系列总览
| 篇目 | 主题 | 主要内容 |
|---|---|---|
| 第一篇 | 项目架构与保存同步 | 从 Electron、多进程和工程结构,到本地保存、云端同步与冲突处理。 |
| 第二篇 · 当前篇 | 本地 Agent 的 Harness 工程 | 作为七猫首个 C 端 agent 产品,沿着一次提问,介绍本地 Agent 的执行架构,以及范围控制、工具约束、消息呈现与结果保存。 |
| 第三篇 | AI 作品资产与作品知识 | 如何生成可复用的作品资产,并让 AI 在边界内检索、读取和引用。 |
本篇阅读路线
- **先看架构:**理解一次提问经过哪些进程,以及为什么需要 Harness。
- **再看执行:**沿着 Run、上下文拼接和工具调用,理解模型怎样获得可用信息。
- **接着看交付:**了解消息如何区分过程与答案,以及完成、失败和中断怎样收敛。
- **最后看边界:**回到开头的人物分析,再用附录核对预算、容量和重试限制。
一次提问,需要模型之外的哪些能力
写到一段剧情的转折处,作者可能会问:“根据当前章,分析主角这次转变是否合理。”这类问题就发生在编辑器里:左侧是章节,中央是正文,右侧是随时可以使用的 AI 面板。下图展示的是同一写作环境中的灵感功能;本文以人物分析为例,说明一次提问在界面背后怎样完成。
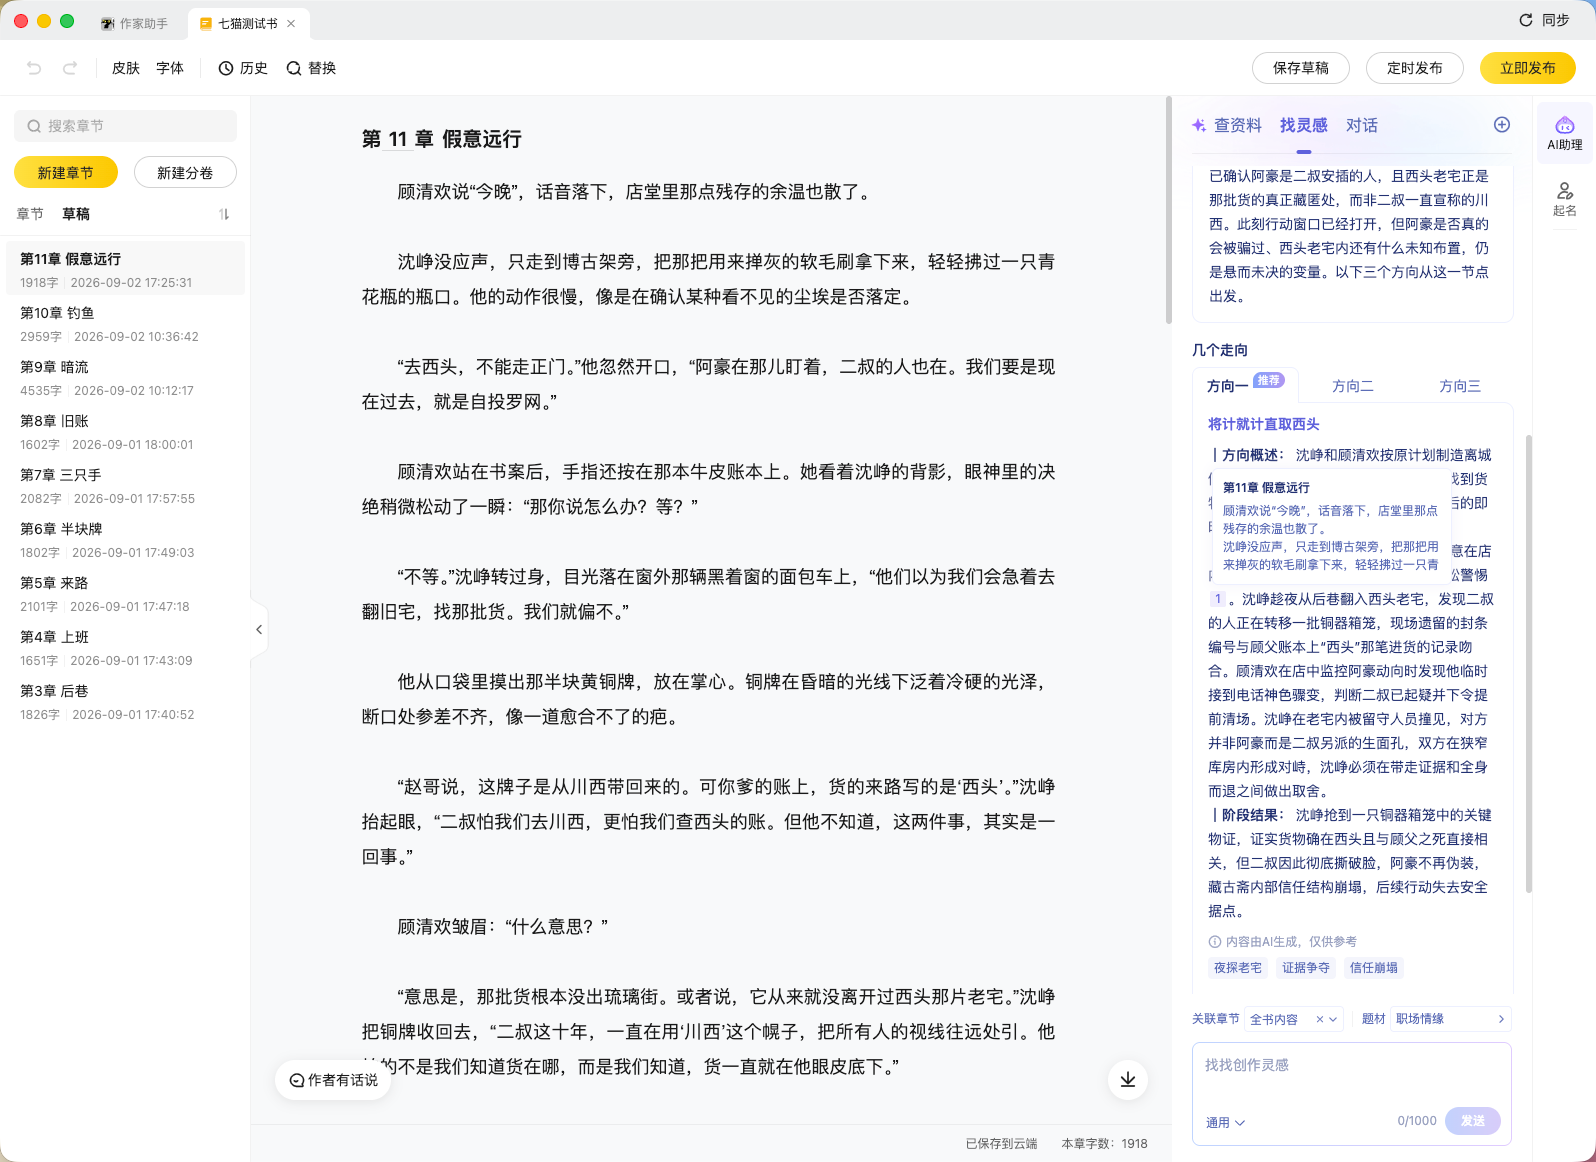
图 1 | 写作现场|正文与 AI 面板并排,灵感建议可以回看所依据的章节。
要回答这个问题,模型需要读到正确的章节,也需要知道什么时候读到的内容已经足够,可以开始给出判断。作品范围、工具权限、执行预算和结果保存,都需要由应用明确管理。
我们把围绕模型建立的这套执行机制称为 Harness:它约束模型能够访问什么、怎样处理异常,以及什么样的结果可以交付给作者。下面沿着“确定范围 → 检索与执行 → 呈现答案 → 保存与恢复”这条路径展开。
先看这次提问会到哪里执行。桌面端负责模型循环和工具编排,模型推理由在线服务提供;作品知识则通过另一条链路准备和下发。本篇顺着实时任务展开,知识的生成与更新留到下一篇。
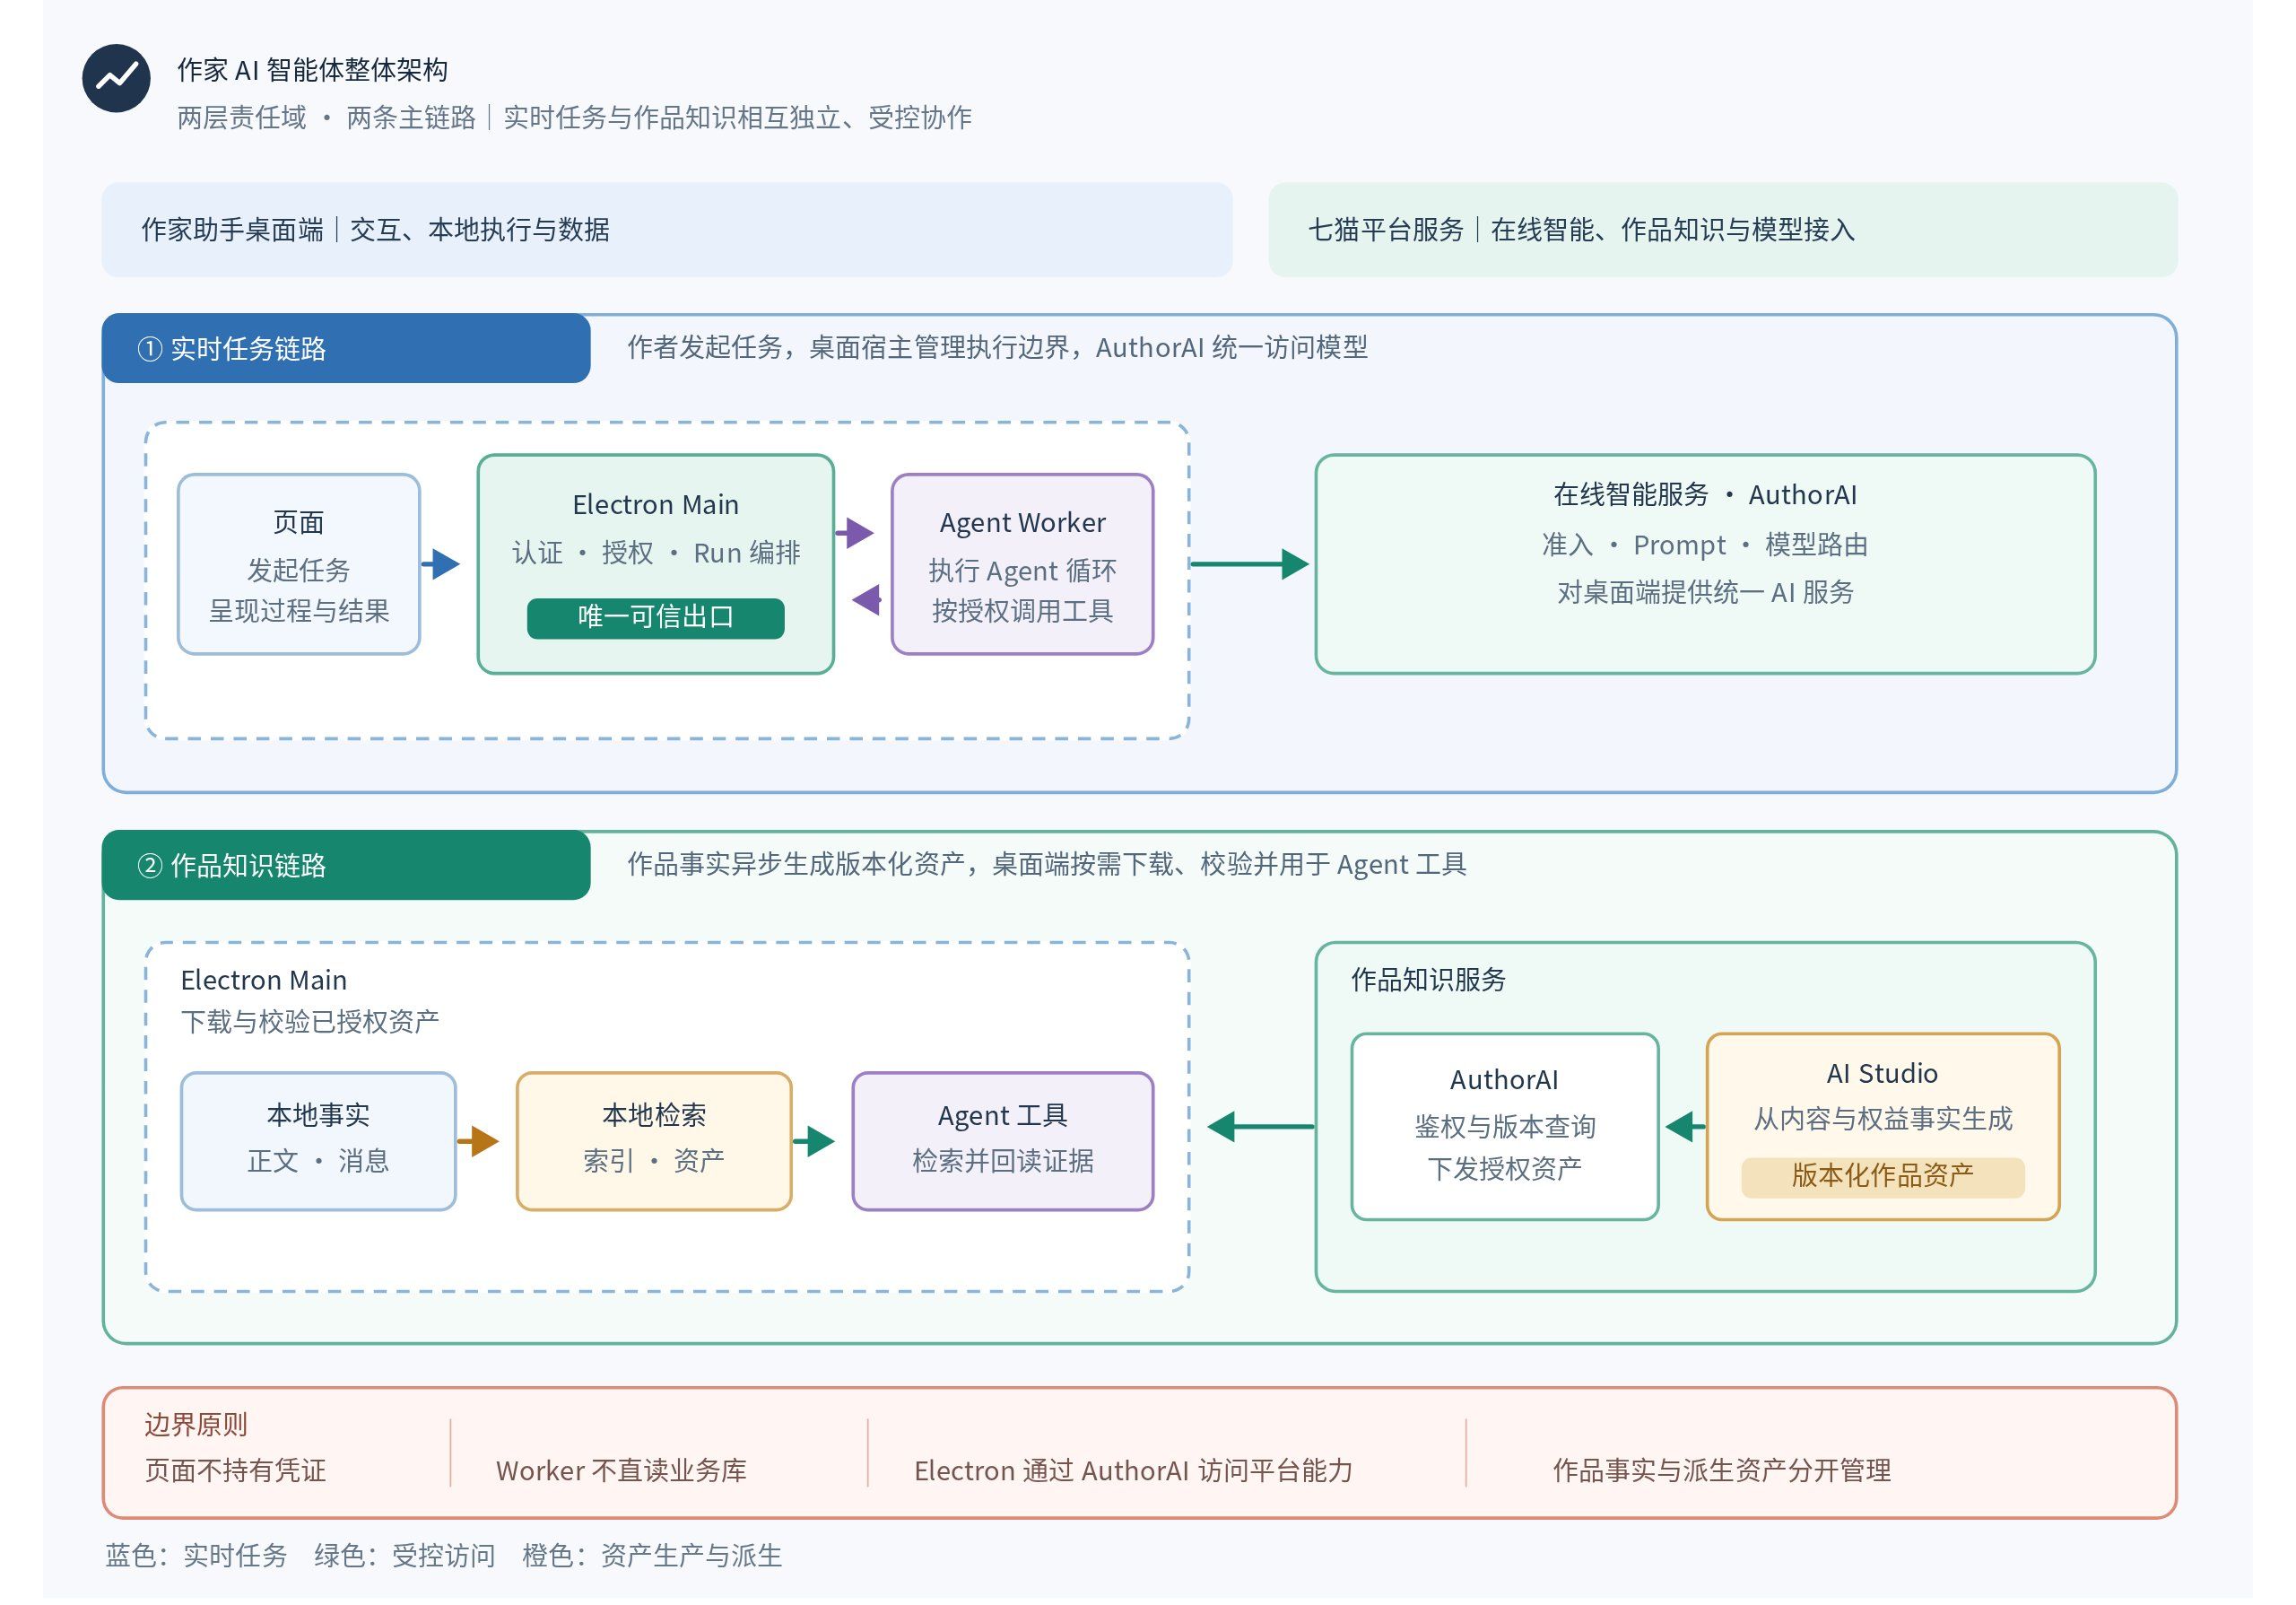
图 2 | 整体架构|实时任务与作品知识各走一条受控链路,下面先进入实时任务。
本地执行,云端推理
把实时任务放大到桌面端内部,可以看到几个不同的职责:
- 页面(Renderer):接收作者的问题,与展示流式结果。
- 主进程(Main): 管理身份、授权、任务状态以及 harness 限制。
- Agent 进程(Agent Worker): 负责在模型与工具之间推进执行。
- 存储进程(Account Storage):负责本地数据库的读取与写入。
- **检索进程(Search Compute):**负责将小说正文进行索引拆分入库,以及 ai 运行时检索。
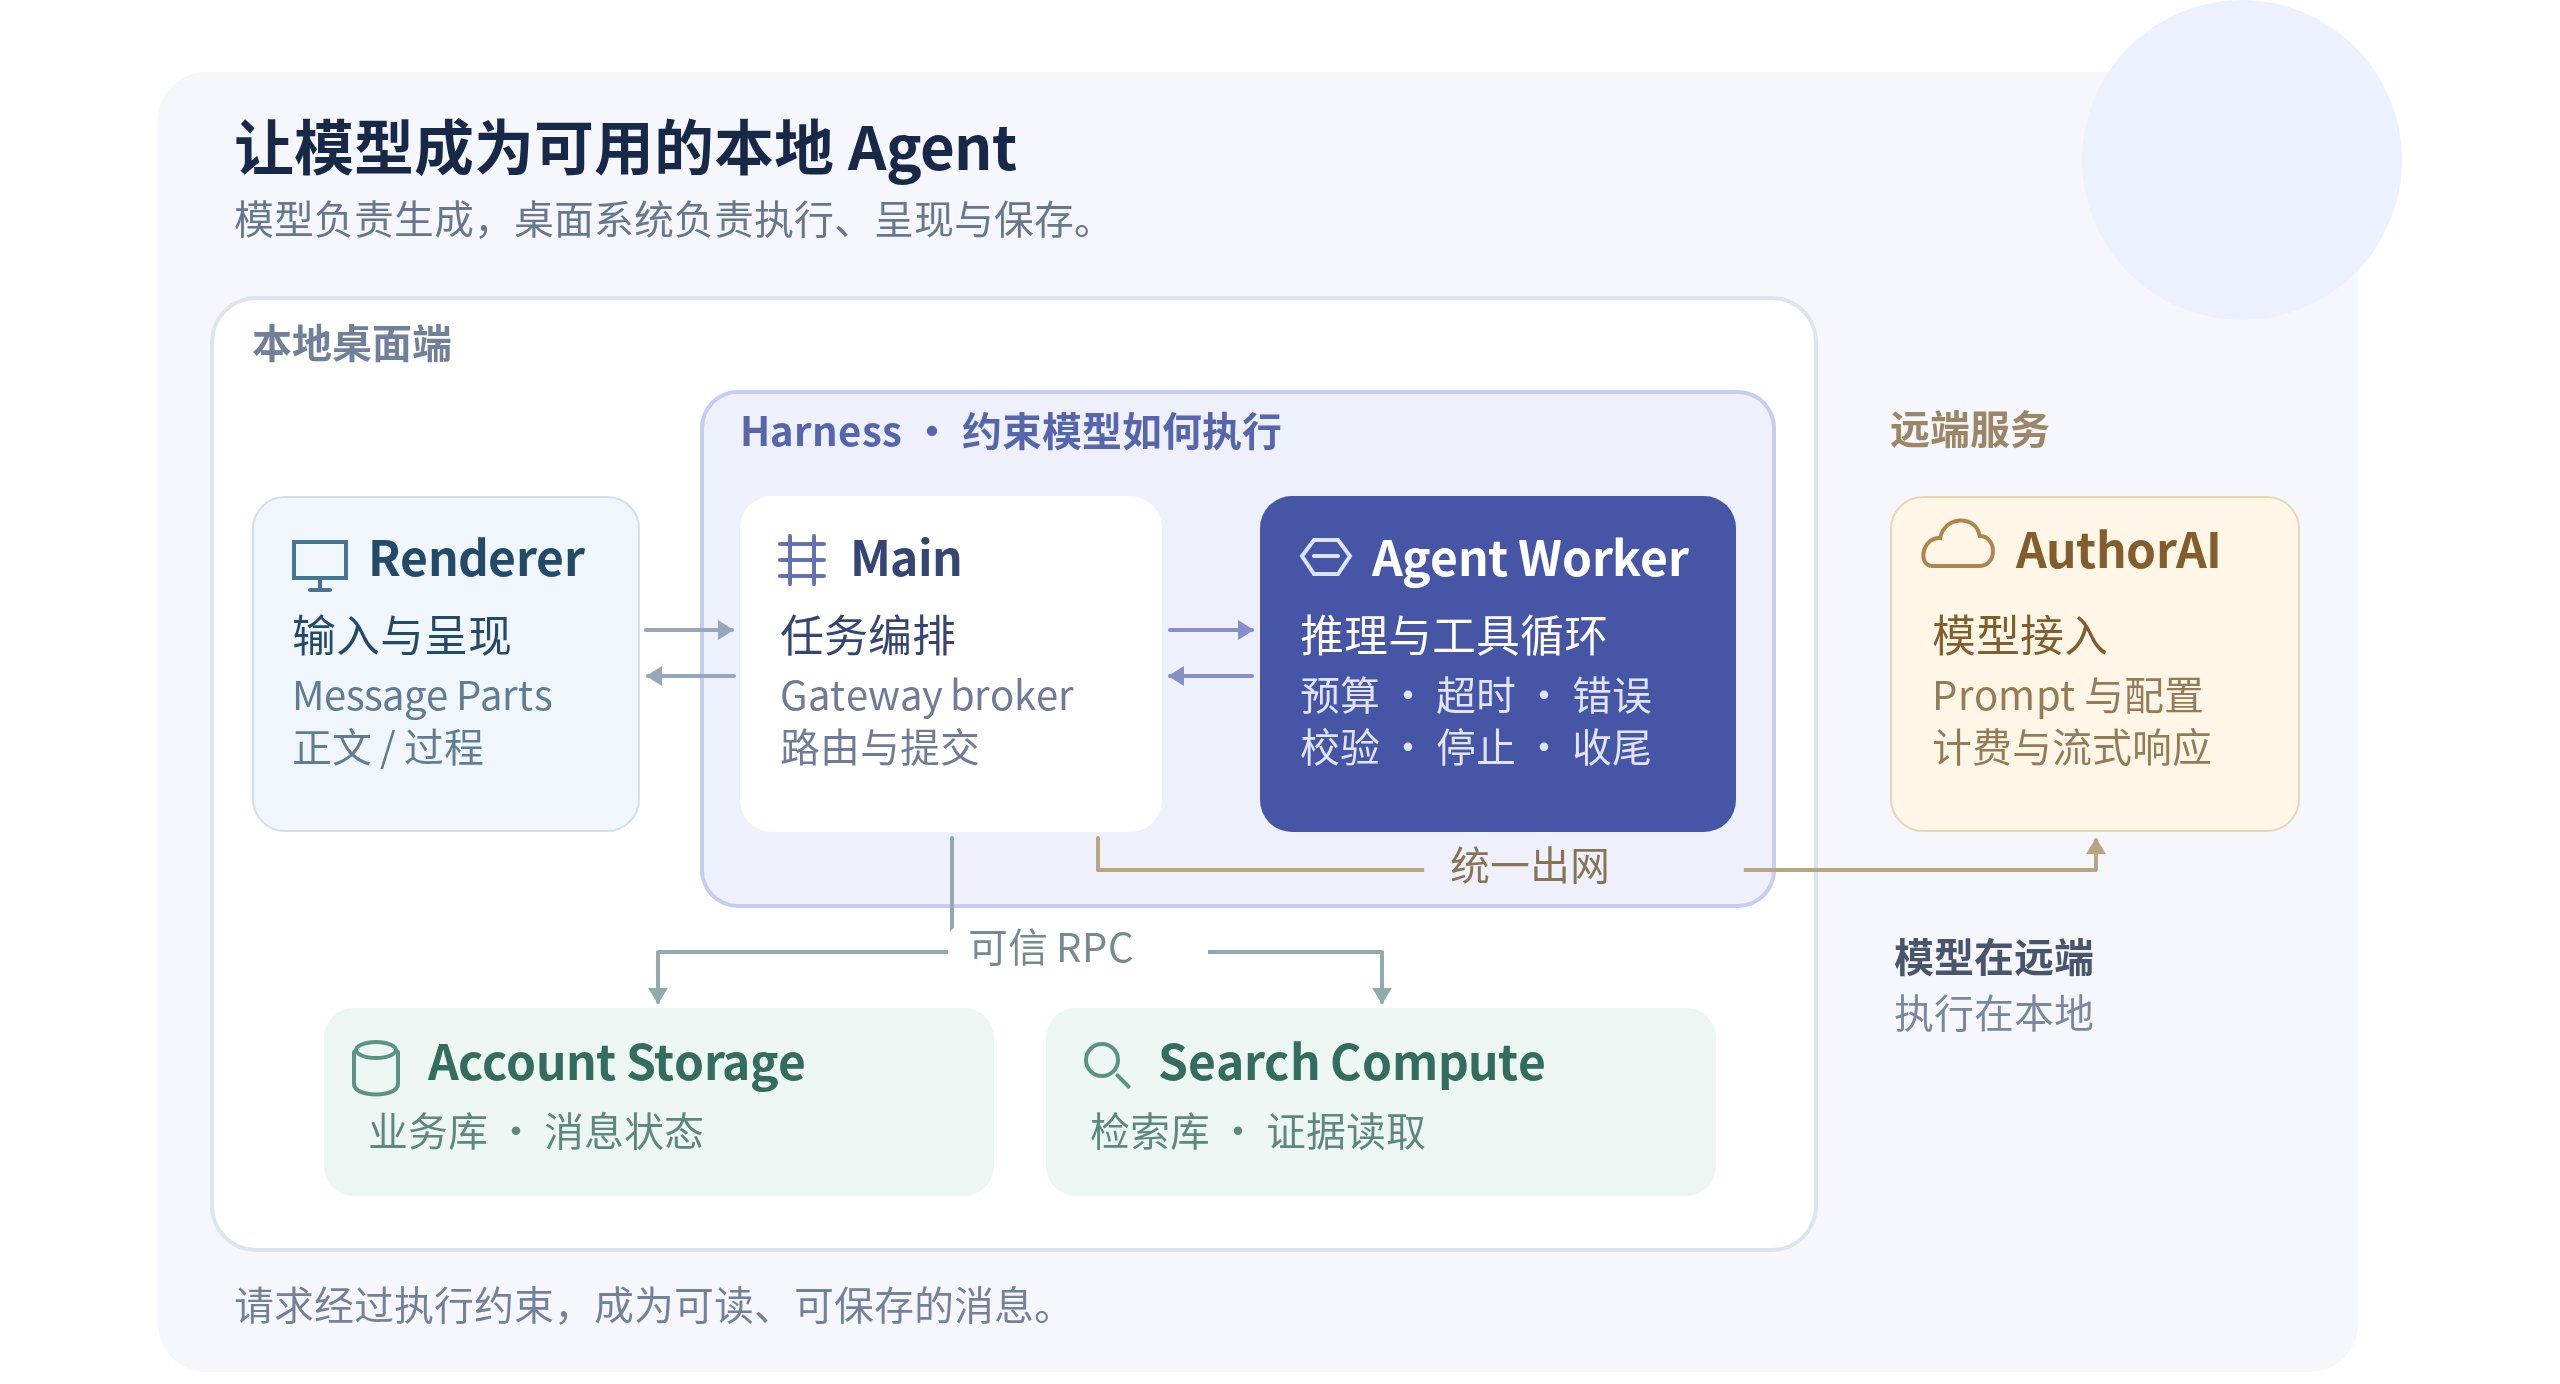
图 3 | 桌面端内部架构|主进程、Agent 进程、Account Storage 与 Search Compute 的协作边界。
这次人物分析需要读取章节时,Agent Worker 通过 Main 校验后的工具入口访问数据。Account Storage 保存业务数据,Search Compute 维护派生检索索引。
凭证留在 主进程,模型循环留在 Worker,工具访问与故障收尾因此都有明确的负责方。
当前主要应用 5 个场景
- 查资料、找灵感和**作品对话:**使用 single Agent:通过对话模式实现问题解答。
- 起名与**全书查冲突:**采用应用预先编排步骤的 fixed Workflow,约束更加严格。
开始执行前,先确定这次任务的范围
作者发出问题后,可能继续追问,也可能切换到另一本作品。系统需要同时保留会话的连续性和本次执行的独立性:
- Thread 是作者看到的会话,一次 Thread 会包含多个 Run
- Run 是其中一次执行,一次 Run 内可以有多次模型调用。
- 持久化接口中的 Session 对应这里的 Thread。
- 后文的“Worker 会话”指执行进程内仍然存活的运行上下文。
创建 Run 时,主进程固定账号、作品、章节范围和工具授权。 这样,即使作者中途切书,正在进行的人物分析仍然读取发起时的作品。同一会话只允许一个活动 Run,账号层还有并发和日额度限制,避免重复启动与无界执行。
- **检查准入:**主进程 检查账号、作品和模式,确定会话归属并创建本次 Run。
- **装配上下文:**带入历史、用户问题和当前定位章节,让模型知道要回答什么、允许检索哪些作品内容。
- **交给 Worker:**准备完成后启动本次执行。Worker 在首次打开 AI 面板后按需初始化,各 Run 复用同一个初始化 Promise;普通写作不需要等待它。
上下文怎样拼接与取舍
上下文也需要取舍。持续追问会积累历史,应用在接近预算时压缩较旧的可压缩内容,但保留用户问题、章节定位和全书查冲突所需正文。受保护内容本身过大时,明确要求缩小范围,避免静默丢掉回答所依赖的信息。
这一步由 Main 的 Context Composer 完成:它先校验账号、作品和 scope,再把问题、必要历史、章节定位与覆盖提示拼成最小初始上下文。需要正文时,模型再通过工具读取,应用不会在启动时把整本书塞进 Prompt。
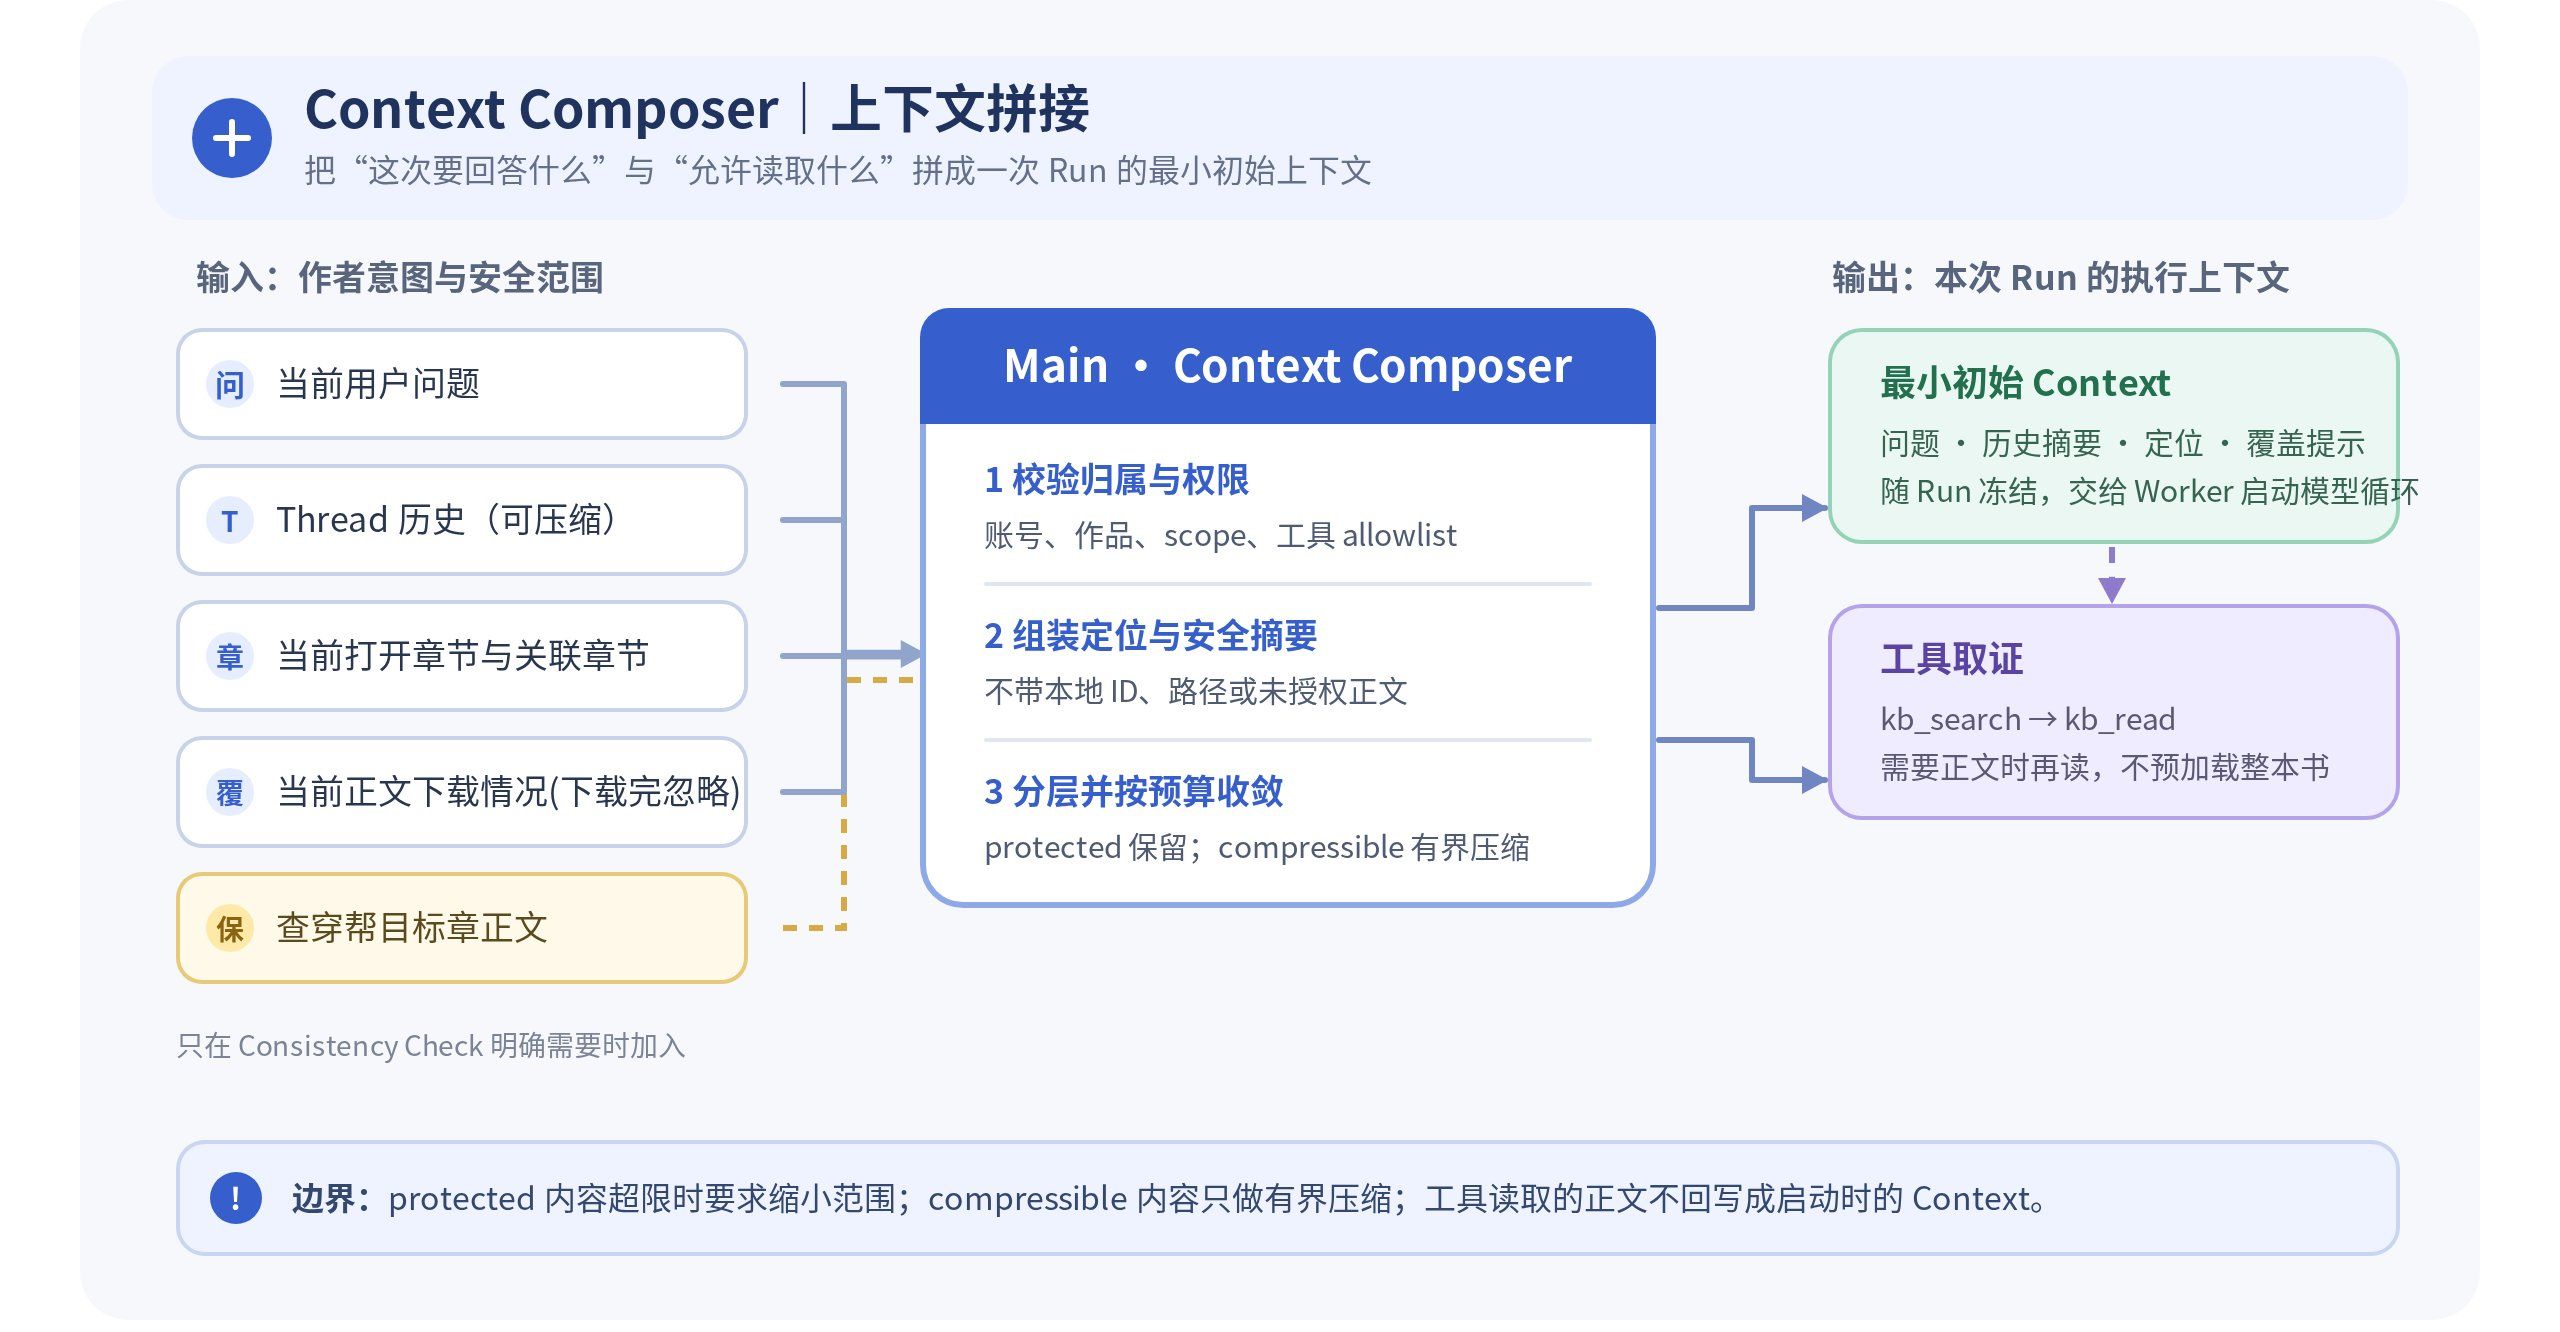
图 4 | 上下文拼接|Main 将作者意图、安全范围和受保护内容分层,按预算生成本次 Run 的最小初始 Context。
准备到这里,模型知道了问题和可检索的范围,但还没有读过章节正文。下一步才是读取内容并推进回答。
执行过程中,怎样检索、读取、控制预算和处理分支
对“主角这次转变是否合理”这样的明确章节问题,仅有章节定位还不够。Worker 会按顺序执行下面两步:
- 执行
kb_list,获取全书章节列表和书籍基本信息 - 执行
kb_search,取得可读取的引用标识 ref。 - 再执行
kb_read读取正文。
这样,回答建立在实际读到的正文上;来源版本变化后,旧 ref 失效,需要重新检索。
随后,模型根据已读内容决定继续查找还是形成答案。每次提出工具调用,都要经过 Harness 的能力、参数、预算、身份和生命周期检查,才能进入产品的数据与网络接口。
工具分工:每个工具负责一件事
| 工具 / 输出通道 | 作用与边界 |
|---|---|
kb_list |
浏览当前 Run 冻结的作品目录。根调用可以返回书名、字数和状态等元数据;下钻目录时只能继续使用返回的 collection ref,并在 complete=true 后才算遍历完整。 |
kb_search |
在授权的章节、随记、资产和引用资料中查找内容,返回摘要、ref 和分页游标。搜索结果只是候选位置,不等于已经读过正文;可以用 within_ref 和 types 缩小范围。 |
kb_read |
根据 kb_list 或 kb_search 签发的不透明 ref 读取正文,按安全块返回并用 next_cursor 续读。ref 绑定来源版本,必须读到 eof=true 才能判断本次来源是否完整。 |
web_search |
为资料研究或查穿帮检索外部信息。它受 主进程 的模式授权、来源配额和超时限制,返回的是经过控制的搜索结果,Worker 不直接持有搜索供应商凭证。 |
fetch_research_source |
读取 web_search 本轮返回并签发的来源正文。只能使用不透明来源引用,不能把任意 URL 直接交给工具;原始网页、签名地址和 Provider 信息不会进入作者界面。 |
ask_user |
信息不足时向作者发起澄清,暂停当前执行并等待选择或补充。每个产品 Run 最多调用一次;作者回答后,在同一 Thread 创建新 Run,继续使用仍然存活的 Worker 会话。 |
emit_idea |
找灵感时提交结构化方向卡。它是输出通道,不是 Tool,不进入 Tool manifest、ACL 或工具调用预算;起名和全书查冲突则由 fixed Workflow 按预设步骤执行。 |
因此,需要浏览目录时使用 kb_list,定位作品证据通常使用 kb_search / kb_read;需要外部依据时再走 web_search / fetch_research_source。作品对话沿用作品知识工具,找灵感则在此基础上增加 emit_idea。工具的详细调用仍由 Harness 统一做权限、参数、容量和生命周期检查。
搜索命中不等于证据成立。
kb_search或web_search只负责找到候选来源,回答前还要通过对应的读取工具取得正文,并确认来源版本和覆盖范围。
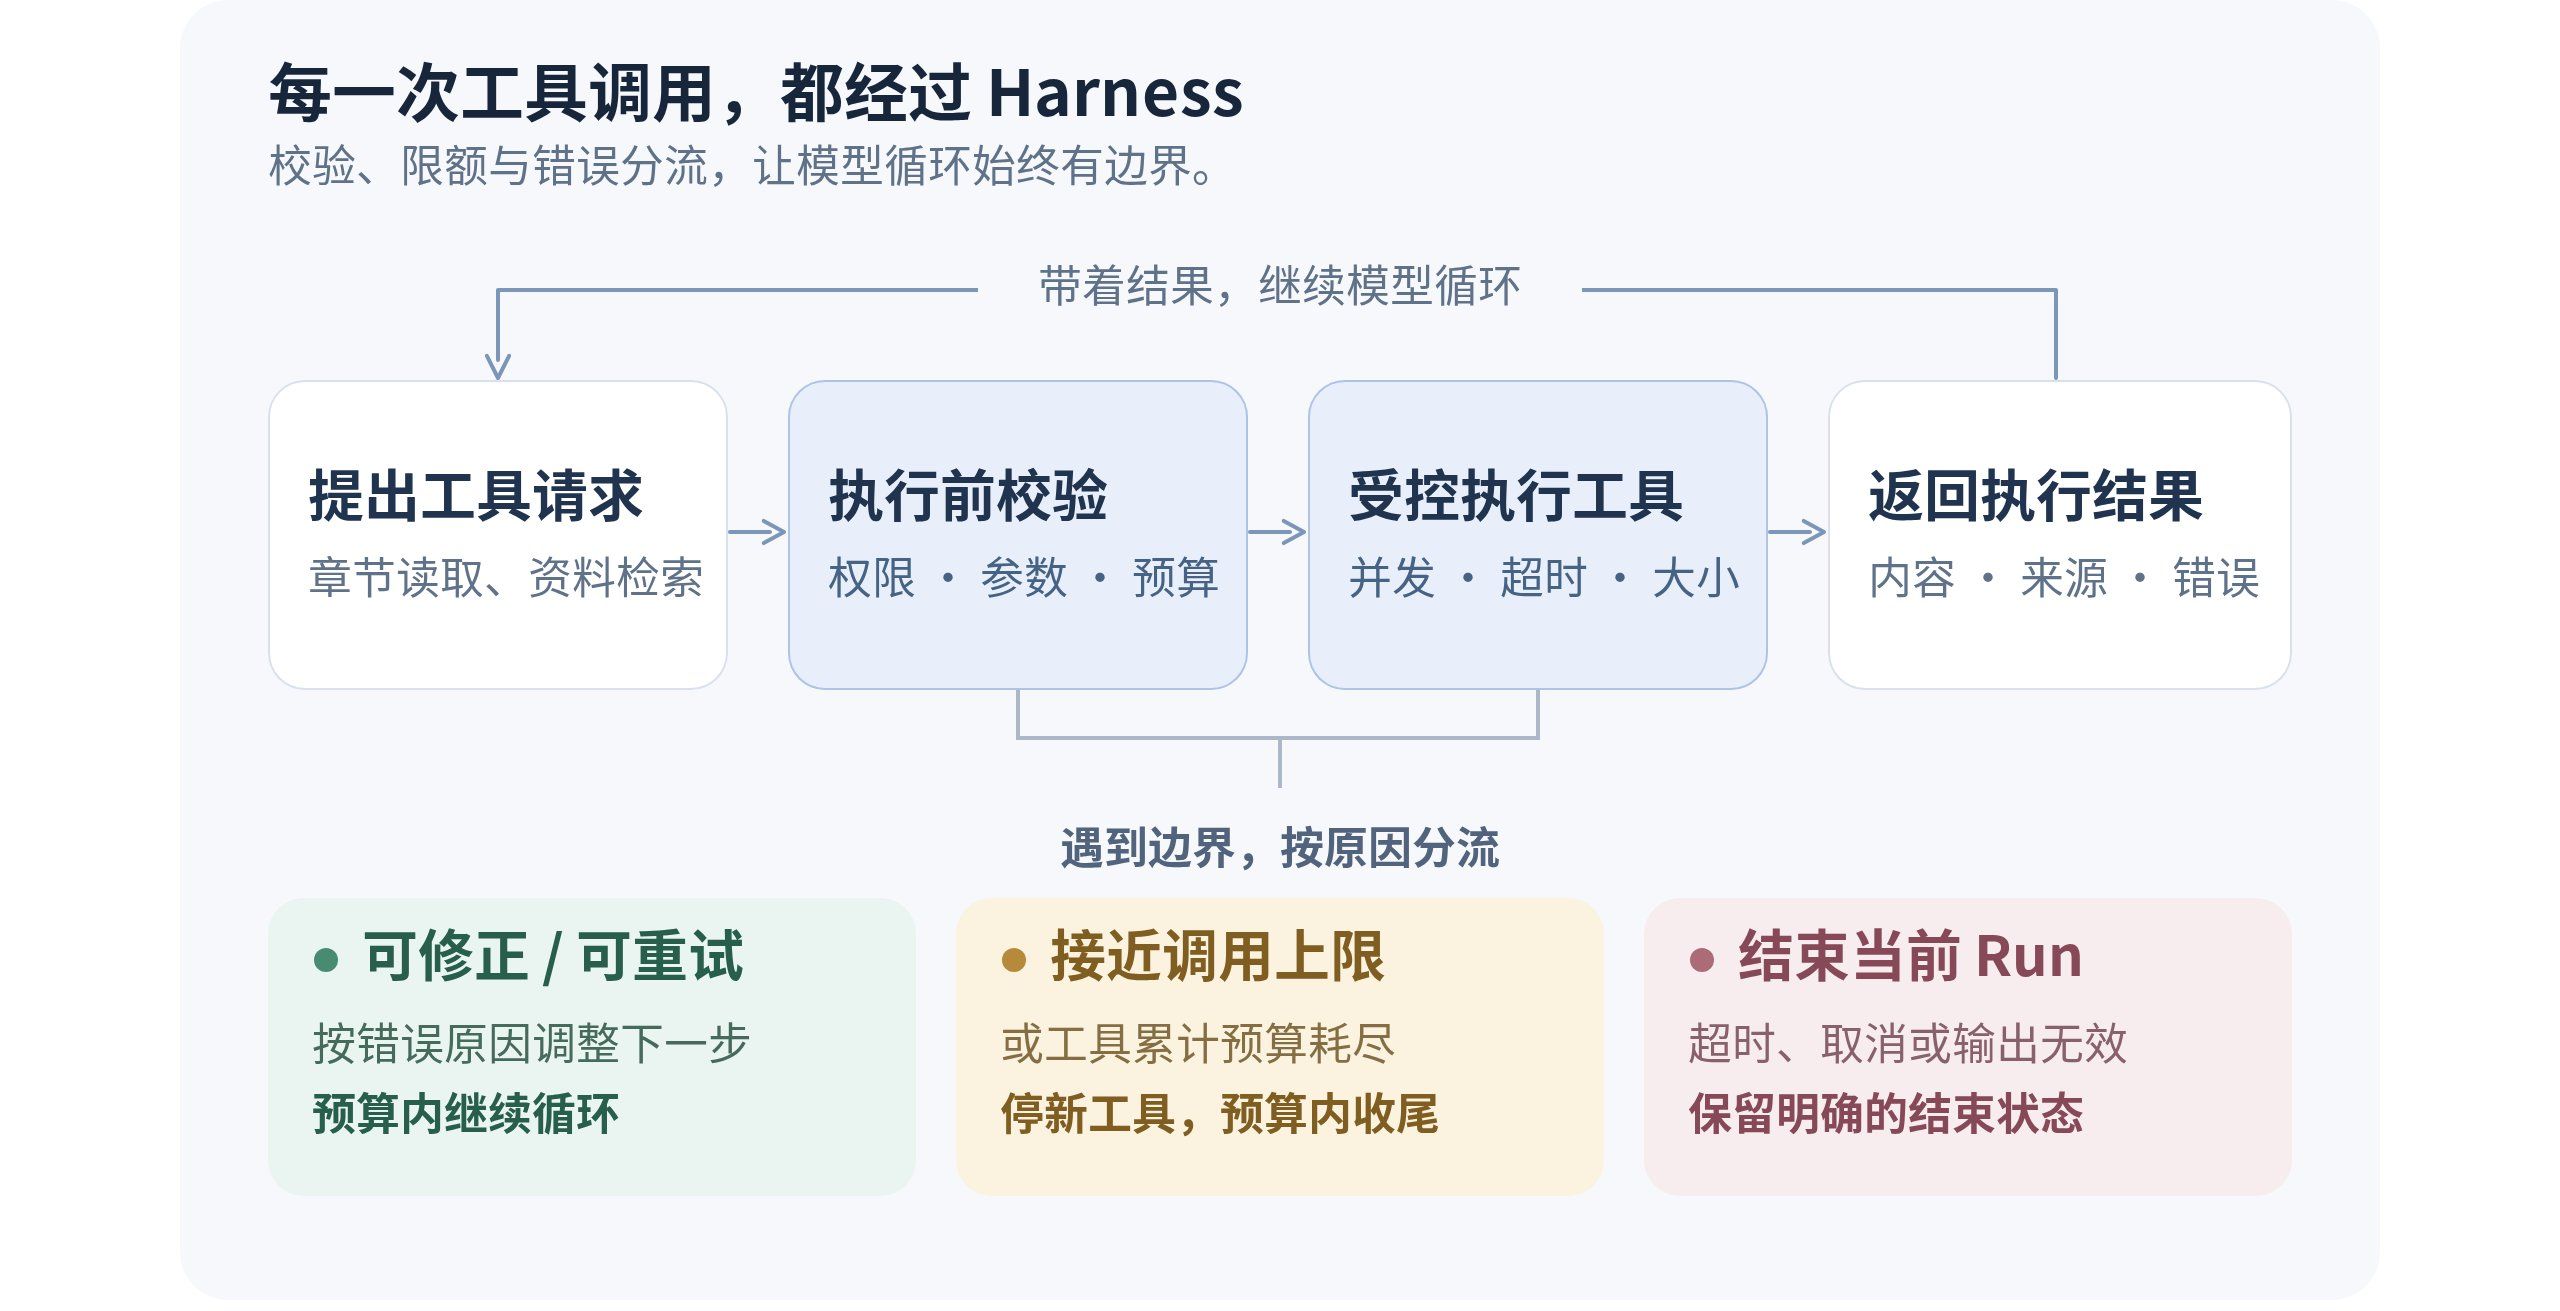
图 5 | 每次工具调用都先过门禁,失败按原因返回、收尾或终止。
给最终回答留出空间
人物分析可能涉及多章前文。如果 Agent 不断补查资料,就可能花完所有调用,最后只留下“我再查一下”。因此,轮数上限除了防止循环失控,还要为最终回答预留空间。
当前在我们的配置中,单 Agent 最多调用 20 轮,最后 2 轮用于收尾;实际预算以本次 Run 下发值为准。工具累计预算提前耗尽时,也会关闭工具:既向模型设置 toolChoice: none,也由执行端拒绝继续调用。模型应基于已获取的内容回答,并说明无法确认的部分。
收尾仍然需要有效输出。如果最终只有工具调用、没有可交付结果,本次执行按输出失败处理;总超时或取消则立即终止。单次工具失败是否值得重试,要结合具体原因和剩余预算判断。
让每次工具访问都有边界
光限制模型轮数还不够:一次响应可能提出多个工具请求,一次读取也可能返回大量正文。主进程 因此在访问数据前检查工具白名单、作品范围、重复调用和容量,并限制并发;执行结束后再次确认 Run 有效,拦住取消后的迟到结果。
这些检查分别约束“能不能读”“一次读多少”和“还能读几次”。例如,章节正文按窗口分页读取;联网 Fetch 按来源计次,失败重试也消耗预算,成功读取过的 query 或来源不再重复请求。具体并发数、字节上限和分场景配额见附录。
工具失败后,决定修正、重试还是结束
假设一次章节读取超过容量限制,缩小范围后仍有可能成功;但如果整次 Run 的工具预算已经耗尽,继续缩小范围重试也没有意义。两者即使使用同一个 CONTEXT_BUDGET_EXCEEDED 错误码,下一步也不同。
因此,主进程 将工具错误整理为稳定的 code / reason / retryable:分别说明错误类别、具体原因和是否可重试。模型据此调整下一步,Renderer 则映射成作者能理解的提示和动作,原始异常、Provider message 和内部路径不会直接交给模型。
| 遇到的问题 | 应用怎样处理 |
|---|---|
| 参数无效 / 单次结果过大 | 返回可修正的失败,允许调整参数;相同输入第三次尝试被拒绝,不能靠换 call_id 无限重试。 |
| 单工具超时 / 临时服务失败 | 按 retryable 和剩余预算决定能否重试。 |
| 引用版本变了 | 旧 ref 读取失败,要求重新检索取得新引用;不会悄悄把新版本正文当成旧引用对应的内容。 |
| 工具累计预算用完 | 失败 reason 为 budget_exhausted,停止新工具,转入预算内收尾;不能继续重试耗尽的账本。 |
| Run 超时 / 取消 / 无效输出 | 收敛到终态;保留允许保存的部分内容。输出 Schema 或安全校验失败,不能当作成功结果。 |
重试还要考虑操作本身。配置和授权查询允许受控重试,模型响应流则不自动重放,以免重复预占额度或把两次生成拼成一份答案。
信息不足时,先等作者补充
执行过程中还有一种正常分支:问题需要作者补充信息,模型才适合继续。例如,作者说“帮我设计一段情节,需要的信息请先问我”,Agent 可以先询问情节类型,并把问题呈现为可选择的澄清卡片:
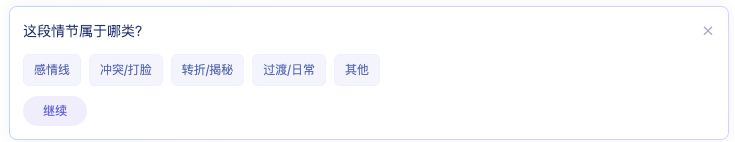
图 6 | 澄清交互|先选情节类型,再继续设计;等待作者输入也是任务的一种正常状态。
卡片由 ask_user 触发:Worker 挂起当前执行上下文,并暂停执行计时。作者补充后,应用在同一 Thread 中创建新 Run,依赖仍有效的 Worker 会话继续处理。这里延续的是同一次交互的上下文;如果 Worker 已重启,消息历史不能自动还原这段运行状态。
执行内容怎样成为作者可用的回答
回到人物分析。作者可能先看到“我先查看相关章节”,接着看到检索活动,最后才收到分析结果。如果把这些内容直接拼成一段文本,复制或保存答案时也会带上中途的说明。界面需要在生成中保留反馈,在完成后区分过程与答案正文。
为此,消息被组织成 Message Parts:正文、思考信息、工具活动、引用和灵感卡各自保留结构。主进程 先过滤 Worker 事件中的敏感字段,统一生命周期和错误码;Renderer 再通过同一套消息累积逻辑更新 Parts,并从中生成各个展示区域。
输入事件
reasoning、text、tool_activity、citation、idea_card、warning。工具 Part 只保存安全状态和稳定错误码,不保存参数与原始输出。
产品投影
过程区读取 reasoning、工具活动和较早正文;答案区读取 canonical text;来源、灵感卡和追问分别从对应 Part 投影。
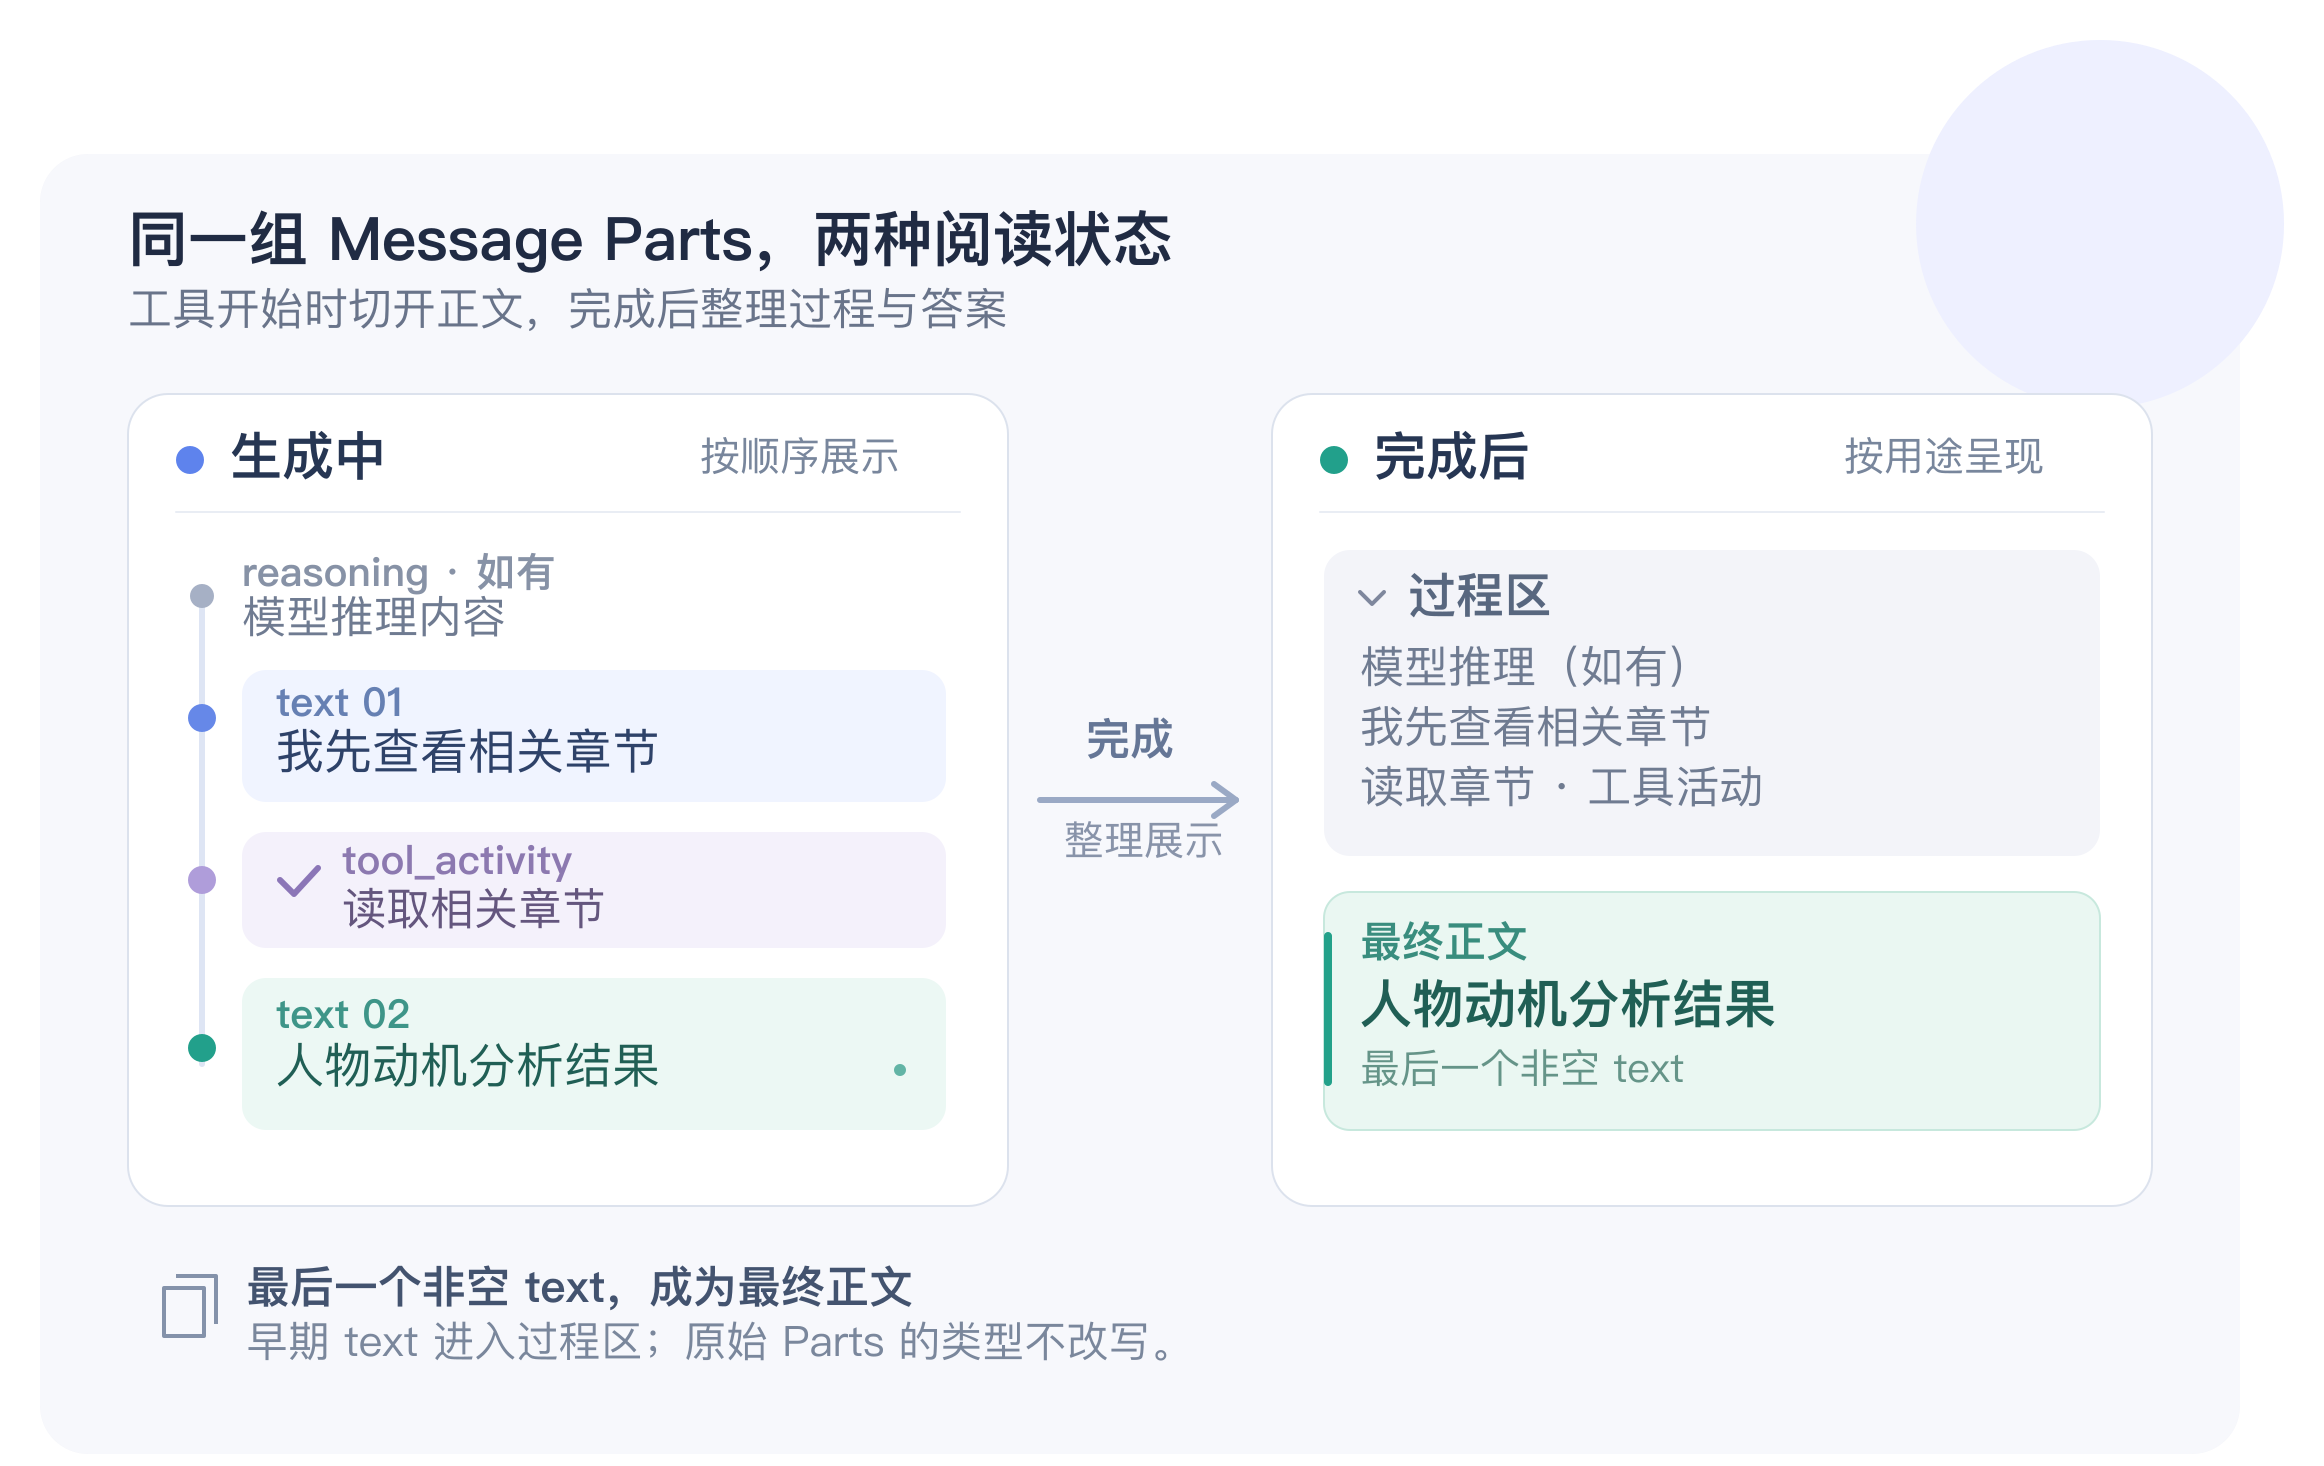
图 7 | 生成中保留反馈,完成后区分过程与最终正文。
在这段执行里,工具开始时会闭合当前 text Part;工具返回后,新到达的正文会开启另一个 Part。保留这些阶段边界,界面就能区分中途说明与最后形成的分析结果。
生成中
所有已到达正文保持可见;同阶段完整重放旧前缀时只呈现新增尾部,避免界面重复。
完成后
最后一个非空 text 作为答案正文;较早 text 连同 reasoning、工具活动进入过程区,原始 Part 类型不变。
因此,界面中的“思考过程”也可能包含早期正文,它不完全等同于模型返回的 reasoning。复制、保存随记和后续模型历史,都从答案正文的投影读取,避免把“我先查一下”当成交付内容。
这里确定的是哪段文字属于答案;本次 Run 是否成功,还要经过后文的输出校验和保存确认。先看消息本身:除了正文,作者还需要阅读引用、比较灵感方向,这些内容也由 Parts 保留结构。
资料回答:让每个引用都有去处
先看查资料场景。作者问“古代驿站如何传递公文”,阅读回答时还会关心依据来自哪里。界面把来源角标放在相关正文旁,悬停可看摘要,回答末尾再列出来源:
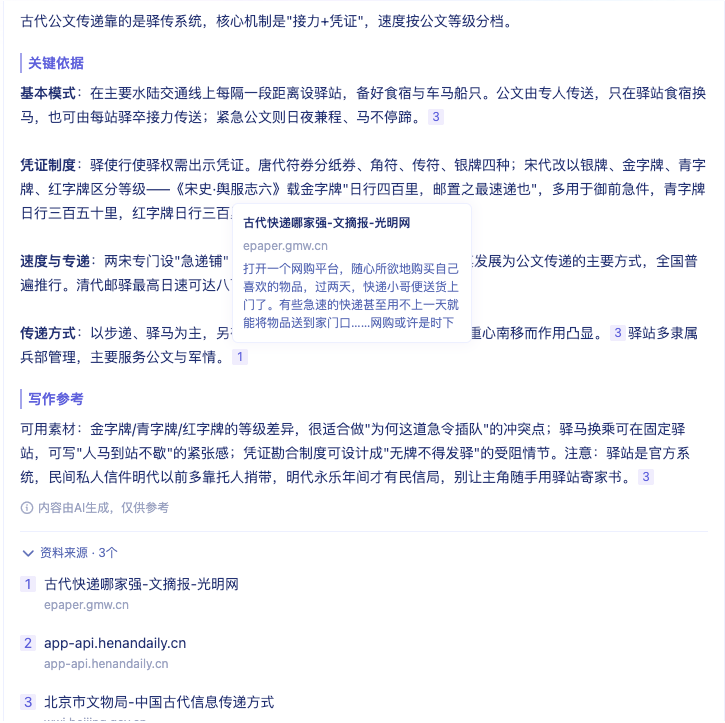
图 7 | 正文角标、悬浮摘要和来源列表,是同一条资料回答的三个阅读入口。
这三处展示共用 citation Part。来源类型、标题和章节信息随消息保存,正文标记与列表编号从同一份来源顺序生成。这样作者重新打开历史时,仍能沿着回答找到出处。
灵感回答:让建议变成可继续的方向
找灵感时,阅读目的又变了:作者希望在几条剧情方向之间比较,再选一条继续展开。下面的面板把“方向概述、剧情推进、阶段结果”收进同一张卡片,并在下方给出继续追问的入口:
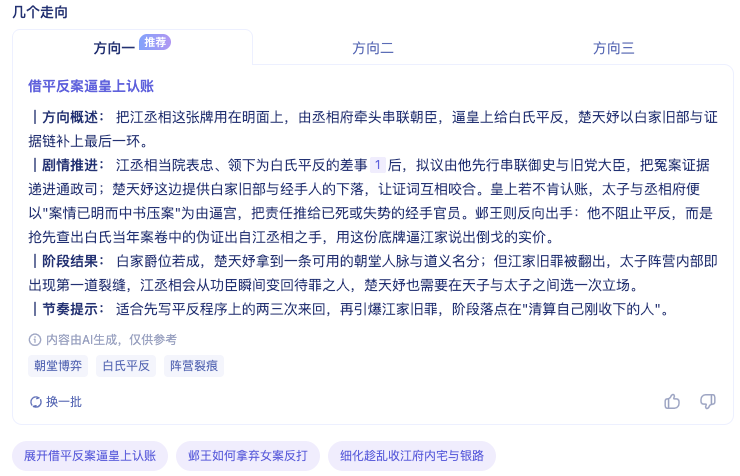
图 8 | 作者先比较方向,再围绕选中的剧情继续追问。
这些卡片来自 emit_idea 的结构化输出,经合同校验后成为 idea_card Part;追问从 followups Part 读取。正文、卡片和引用各自有结构,Renderer 才能把它们组合成同一次回答。
什么时候算完成,中断之后还能保留什么
页面显示出答案后,还需要把结果可靠地保存下来,并向服务端确认成功、完成额度计次。如果先计次再保存,本地写入失败时就可能出现“已经计次,却没有可回看的结果”;如果结果已经保存,只是确认请求暂时失败,也不应该重新调用模型生成一遍。这决定了下面的保存顺序。
Account Storage 保存 Thread、用户消息、助手消息和 Run 状态。历史读取以版本化 Message Parts 为准,AG-UI 等实时运行事件不逐条写入历史,Renderer 也不另存一份会话记录。
持久保存
threads 记录会话,thread_messages 保存版本化 Parts,agent_runs 记录本次运行状态。下次打开,从正式消息读取同一份正文、过程和引用。
只保留在活动期
工具授权、预算账本、取消信号、消息累积快照和 Worker 会话。逐 token 事件不逐条写库;起名、全书查冲突走专用非历史结果通道。
正文型 Agent 在模型结束后,先做输出结构与安全校验。校验通过的结果以暂不公开的助手消息候选(hidden assistant candidate)进入保存流程:
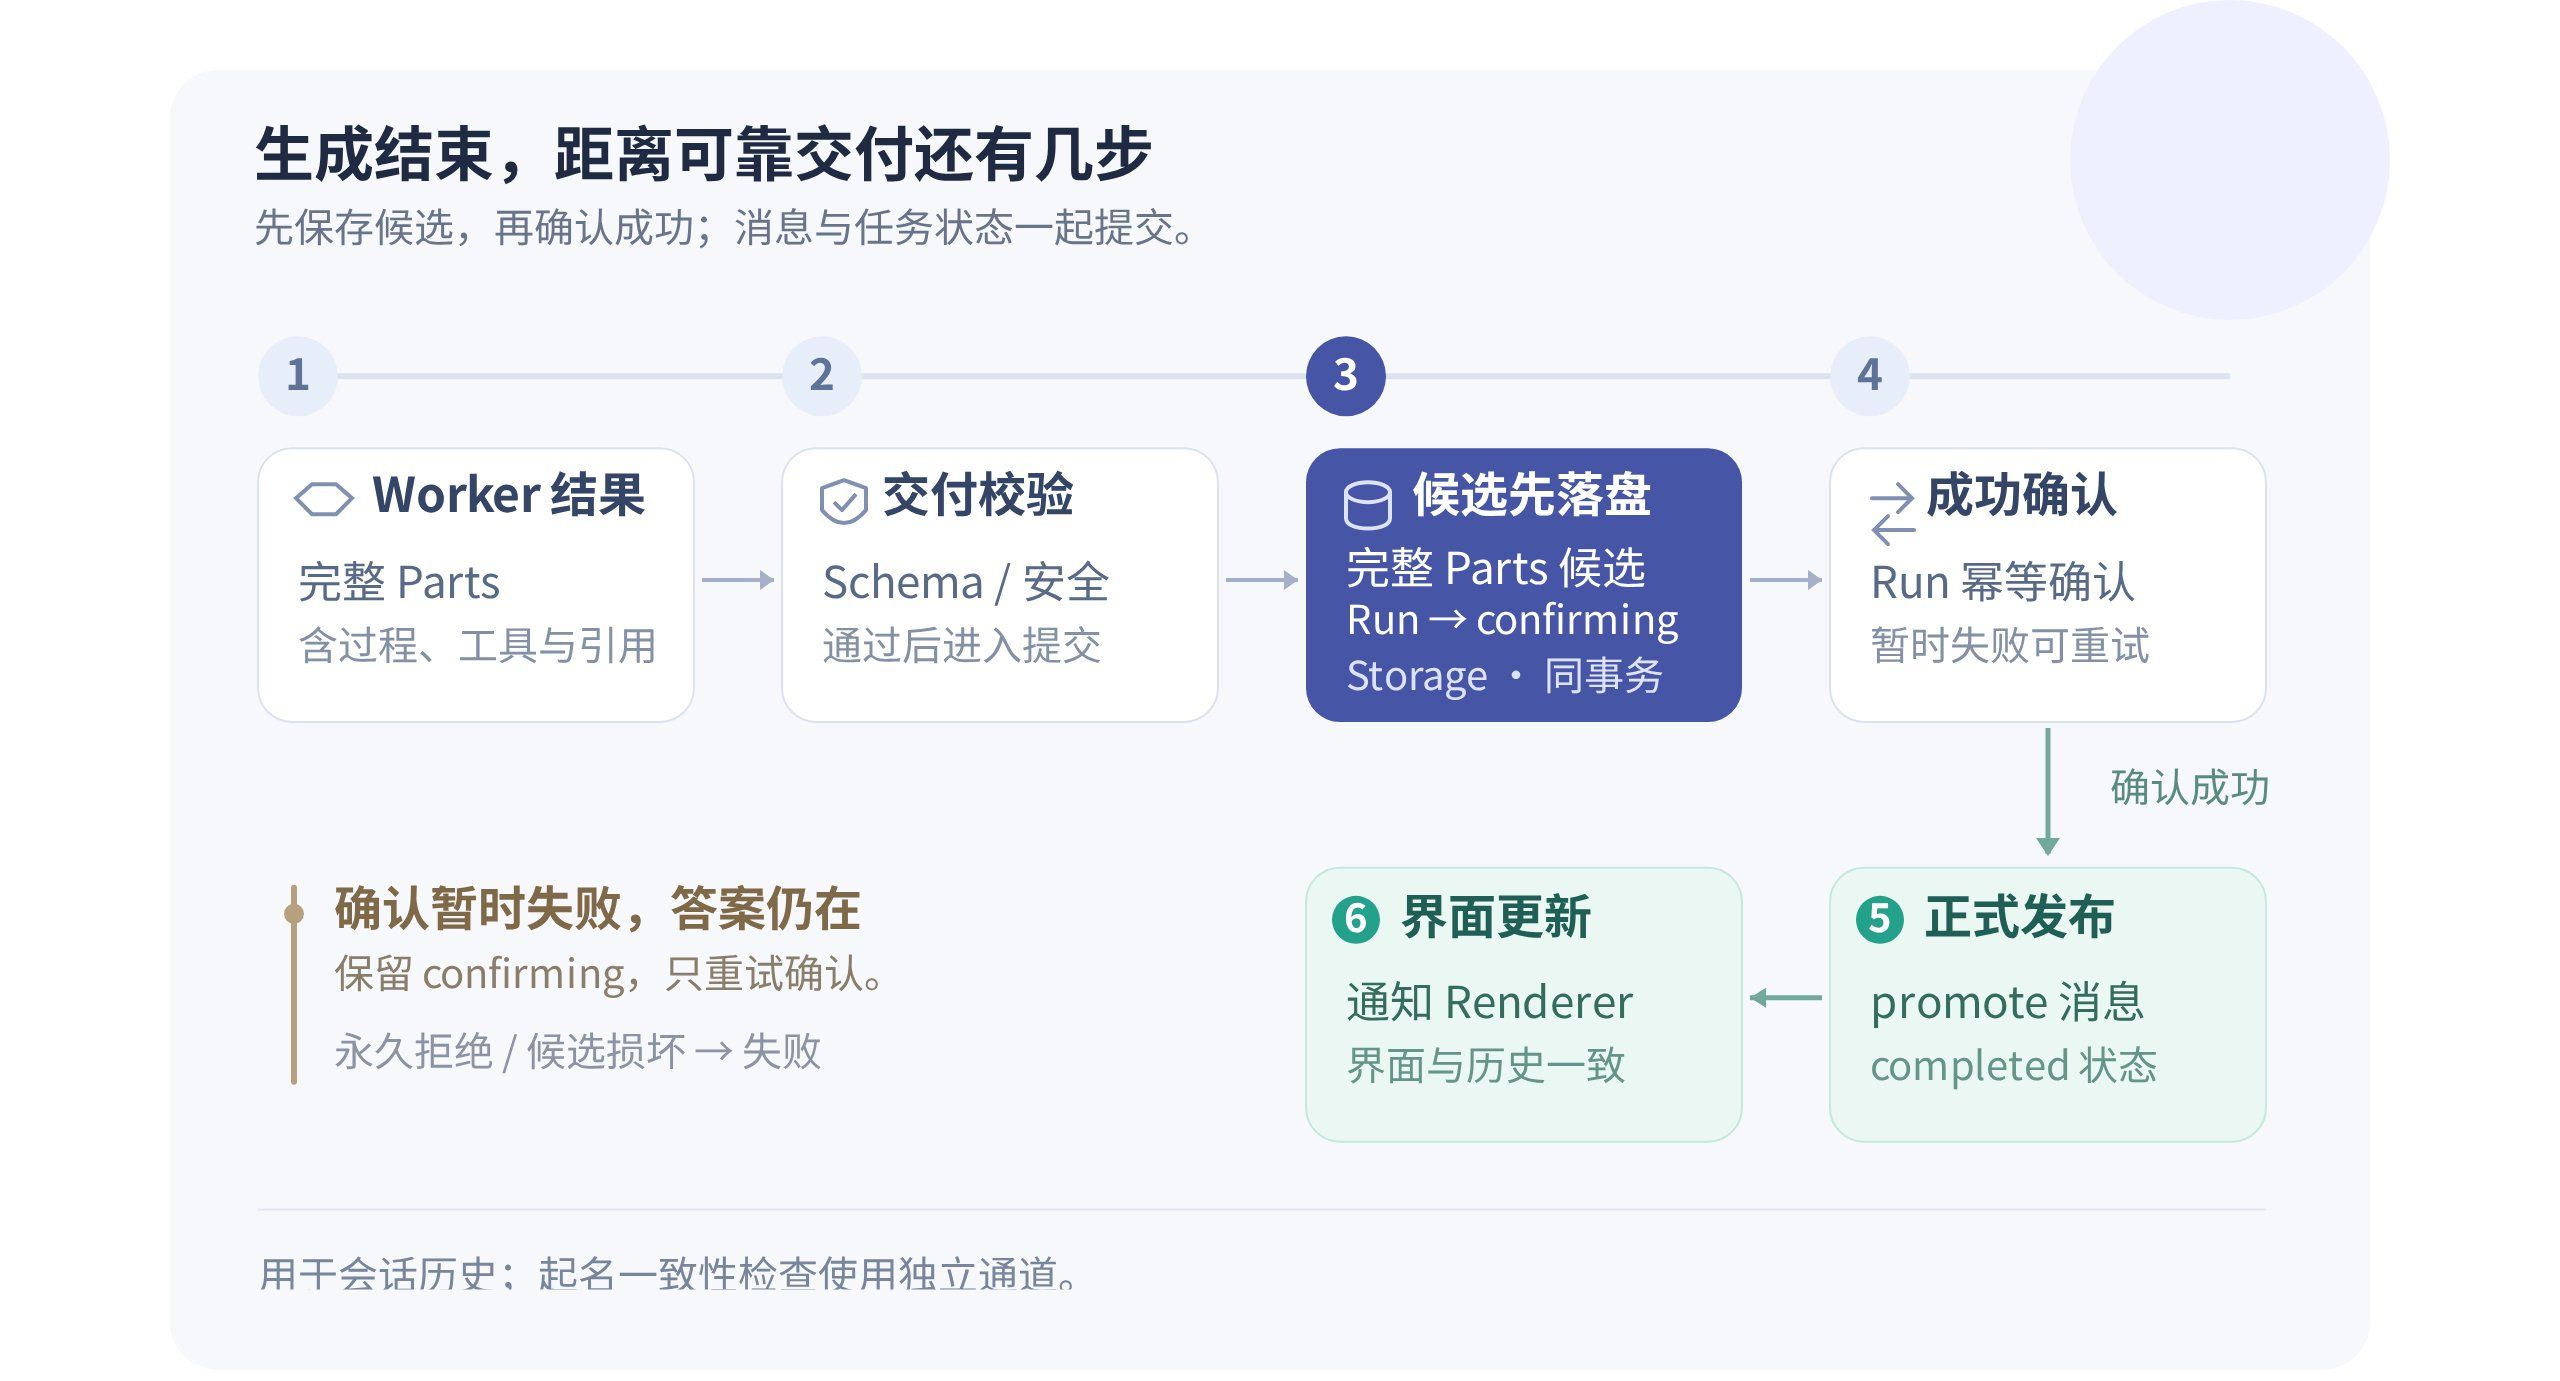
图 9 | 完整候选先落盘,确认后原子公开。
- **候选:**完整 Parts、hash 和 Run 的 confirming 状态在同一事务中提交。
- **确认:**主进程 向服务端发起按 Run 幂等的成功确认,完成成功额度计次;网络暂时失败时保留 confirming,不重新调用 Worker。
- **公开:**本地事务将候选转为正式消息(promote),同时将 Run 标记为 completed,再向 Renderer 发终态通知。
**中断时保留真实状态。**允许保存的部分内容应带着中断状态进入历史,不能标记为成功结果。
先看中断发生在哪个阶段
作者可能在等待澄清、生成答案或确认结果时切书、关 Tab,也可能让电脑睡眠。恢复策略取决于哪些状态仍然存在:运行中的 Worker 上下文、已落盘的候选,还是已经发布的正式消息。
| 场景 | 收尾行为 |
|---|---|
| 切作品 / 收起面板 | 原 Run 继续使用发起时的作品范围;关闭面板不自动取消。 |
| 关闭 Tab / 切账号 / 退出 | 取消在途 Run,保留安全的已生成部分和真实中断状态。 |
| 睡眠 / Worker 崩溃 | 收敛为中断或失败;旧模型循环不跨重启自动续跑。 |
| 已保存候选等待确认 | 只恢复 confirming 确认与发布,不恢复模型循环。 |
因此,本文中的“恢复”有三种场景:
- 面板重挂载时,用 主进程 快照和事件序号接续仍在活动的任务,避免重复追加;
- 成功确认暂时失败时,重试已保存候选的确认与发布;
- 重新打开应用时,从正式历史还原消息。
它们恢复的对象不同。Worker 或应用重启后,不会仅凭消息记录自动续跑旧模型循环或旧澄清会话;已保存的 confirming 候选则可以单独恢复确认,无需再次调用模型。
执行之外,还要控制开销并能定位问题
走完这条路径,Agent 已经具备检索、回答和保存的能力。但它运行在写作应用里,还会与输入、切章、保存和后台同步共享资源,因此需要同时约束执行侧与展示侧的开销。
执行侧
Worker 按需启动;工具读取有并发、字节和时间上限;完整消息集中落盘,减少逐 token 数据库写入。
展示侧
流式文本合并后跨进程传输,Renderer 按节奏提交投影;历史与实时内容复用 Parts 和模式组件。
这些措施约束开销,但实际体验仍需在大作品、多 Tab、后台同步与 AI 并发时测量,关注首字时间、内存,以及输入、切章和保存响应。
排查“界面有字,最后却失败”,接入客户端日志分析平台,在 logs/agent.log 用 run_id 串起工具、输出校验、候选保存、确认与通知,再用 call_id 区分模型请求。日志保留脱敏、限大小的上下文信息,避免把正文和内部错误无边界地写入日志。
回到这次人物分析
对于开头的人物分析,整条路径现在连了起来:Run 固定作品范围,工具读取相关章节,Harness 为检索、读取和回答分配预算;消息把过程、答案与引用分开,最后通过本地保存和成功确认完成交付。
作者能够继续追问或回看历史,工具调用权限,模型不进入死循环,依赖的正是这些模型之外的工程机制。
这条路径还有一个前提:检索到的作品内容足够可靠。章节怎样变成可复用的资产,内容变化后怎样校验来源,以及模型如何读取和引用,下一篇将展开《AI 作品资产与作品知识》。
附录:当前参数与容量边界
准入与上下文
| 边界 | 当前规则 |
|---|---|
| 账号 | 最多 4 个活动 Run;超过后不再新建任务。 |
| 会话 | 同一 Thread(持久化接口中的 Session)同时只允许 1 个活动 Run,数据库唯一索引做最后一道防线。 |
| 作品范围 | Run 创建时冻结账号、作品、章节 scope、工具授权;切换编辑器作品不会改变在途 Run。 |
| 模型调用 | single Agent 的最大调用轮数来自服务端冻结配置;客户端不另写一套数字。 |
| 日额度 | 服务端仓库默认每日成功额度 500;由服务端统一准入和计次,重新生成、换一批与新问题都是用户动作。 |
上下文预算
达到 input_token_budget 的 70% 才启动一次确定性压缩,目标压到 50%;
受保护内容
用户问题、章节定位和全书查冲突所需正文不能被压缩;保护区超过 80% 直接返回
PROTECTED_CONTEXT_TOO_LARGE。
模型调用与任务时限
| 边界 | 当前规则 |
|---|---|
| 模型轮数 | 单 Agent 最大轮数 20;最后 2 个 step 留给回答。服务端 100 次硬上限只用于防失控,不能当成客户端可用轮数。 |
| 任务时限 | 服务端执行窗口 300 s;客户端另留 30 s 传递错误并收尾,下游调用不能超过 Run 剩余时间。 |
| 请求与失联 | 客户端短请求 10 s、Gateway 无活动 70 s;服务端首字 60 s、流空闲 30 s、单次模型调用 180 s。 |
固定 Workflow 有自己的步骤边界。全书查冲突最多进行 16 次分段主张抽取、2 轮补充检索;它仍受总时限与工具预算约束,不套用单 Agent 的 20 轮。
工具访问与联网额度
| 工具边界 | 规则与作用 |
|---|---|
| 授权与重复 | 按场景和 Workflow 步骤授权;同一 tool_call_id 复用同一参数,换参数即冲突。换 ID 提交相同输入也最多尝试 2 次。 |
| 并发与累计大小 | 每 Run 最多 3 个并发工具;累计参数 256 KiB、累计结果 4 MiB。输出超限时不交付给模型。 |
| 单次执行 | 120 s 兜底,并受 Run 剩余时间约束。 |
| Research 联网 | Search 1 次、Fetch 8 次,165 s 后不再发起新联网调用;服务端硬上限 4 / 8。 |
| 全书查冲突联网 | Search 6 次、Fetch 12 次,无额外软截止;服务端硬上限 8 / 16,仍受总时限限制。 |
| KB 分页读取 | 目录页最多 100 项,完整响应 64 KiB,正文读取窗口 30 KiB,用 cursor 接续。 |
| 联网响应 | Search query 最多 512 字符、结果 8 项、完整响应 16 KiB;来源摘录最多 32 KiB。 |
安全重试与消息容量
配置、Manifest 和资产授权查询使用白名单重试,最多 3 次并以 200 / 400 ms 退避;模型流不在这张重试白名单里。这样“能重试”是操作语义与错误合同共同决定的,不是看到 HTTP 失败就重放。
消息结构最多包含 512 个 Part、1,024 个嵌套项;单个 text/reasoning 上限 65,536 字符,累计文本上限 1 MiB。承载完整消息的数据包和终态更新包(terminal patch)各限 2 MiB;用于重新接入活动任务的初始快照(attach seed)限 3 MiB。实时传输与历史存储都遵守这些容量校验。