这个系列用三篇介绍作家助手桌面版的技术实现:第一篇从项目架构讲到本地保存与云端同步,第二篇介绍 AI 本地harness 工程,第三篇介绍作品资产生成以及 AI 如何在边界内使用作品知识。
系列总览
| 篇目 | 主题 | 主要内容 |
|---|---|---|
| 第一篇 · 当前篇 | 项目架构与保存同步 | 从 Electron、多进程和工程结构,到本地保存、云端同步与冲突处理。 |
| 第二篇 | 本地 Agent 的 Harness 工程 | 如何在作家助手内搭建本地智能体。模型外,做了哪些 harness 工程 |
| 第三篇 | AI 作品资产与作品知识 | 如何生成可复用的作品资产,并让 AI 在边界内检索、读取和引用。 |
💡 本篇阅读路线
本篇从产品界面讲起,介绍 Electron 的运行方式、各进程的职责和代码的组织方式,再沿一次章节保存解释本地事实、远端确认与冲突恢复。读完后,读者可以把一个界面功能对应到运行模块与代码位置,也能区分“本地已保存”和“云端已同步”。
项目介绍
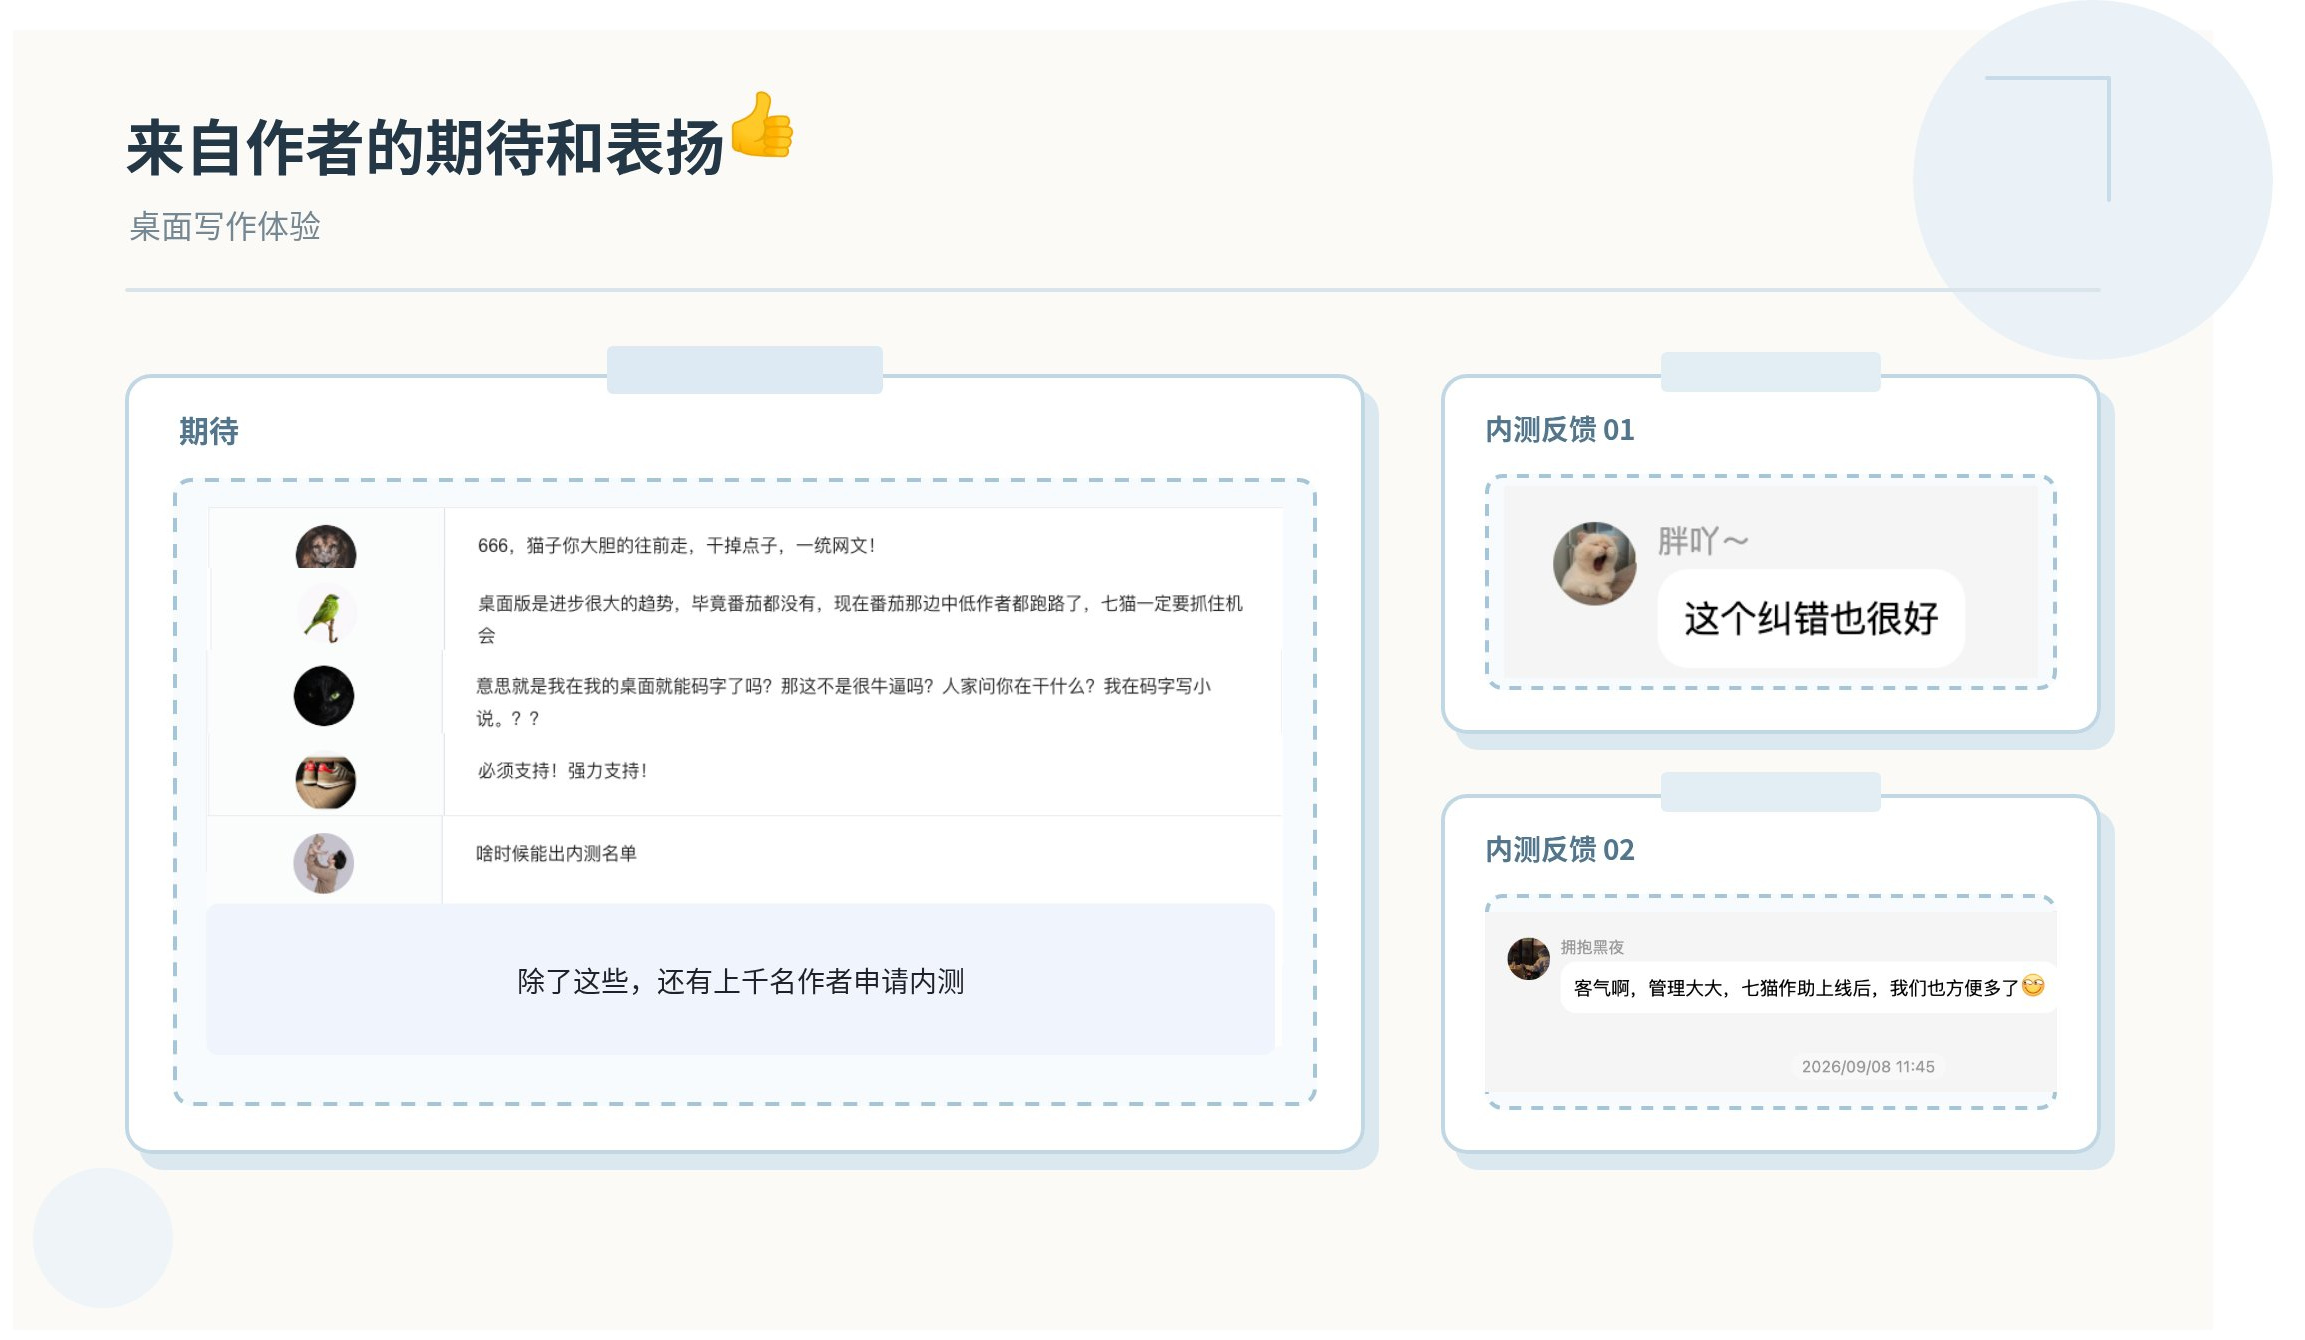
介绍前先看几个来自作者的期待和表扬
产品功能
作家助手桌面版(AuthorWrite)是一款面向 Windows 和 macOS 的桌面写作应用,提供作品管理、章节编辑、本地保存、搜索和 AI 辅助等能力。
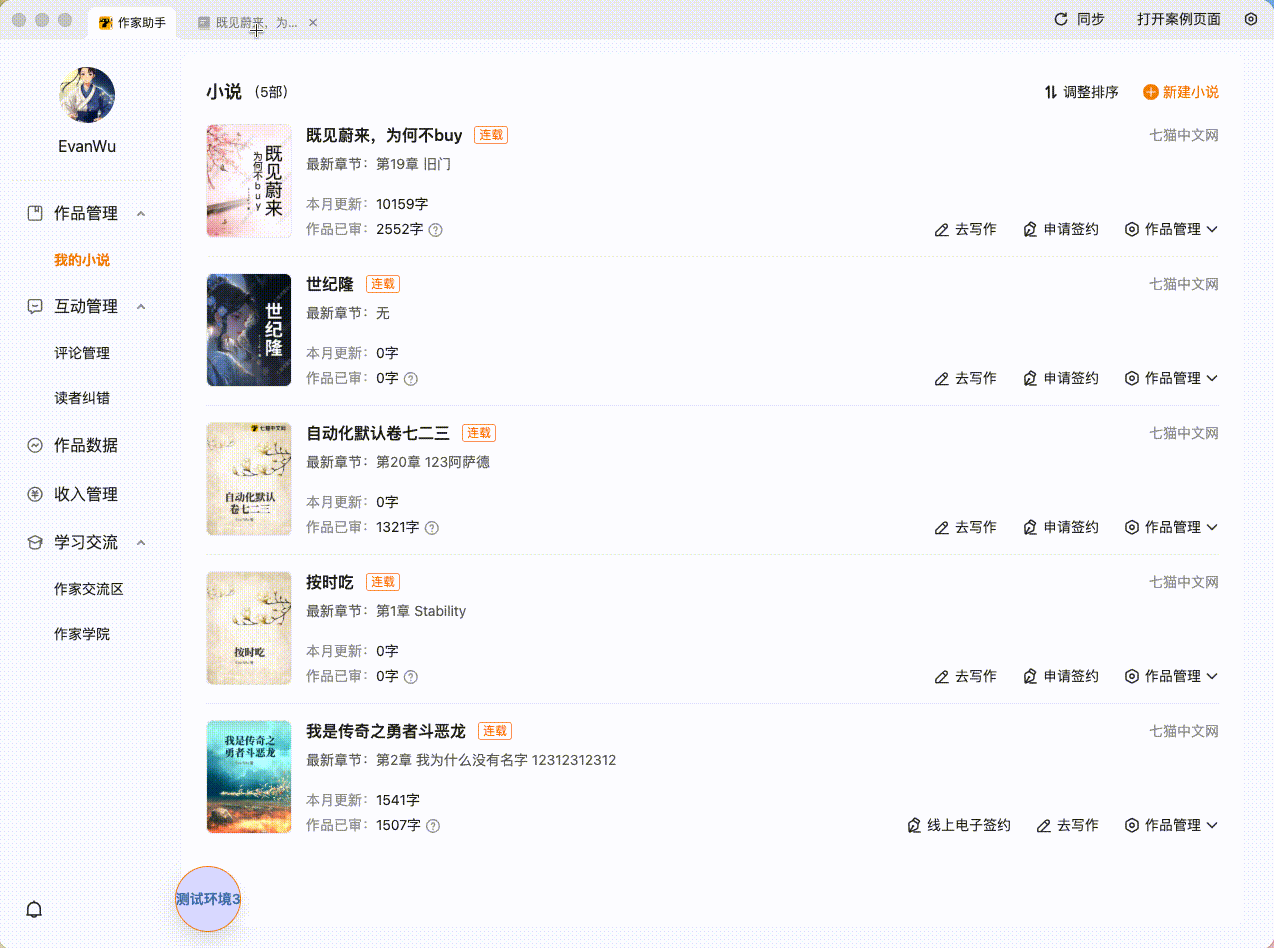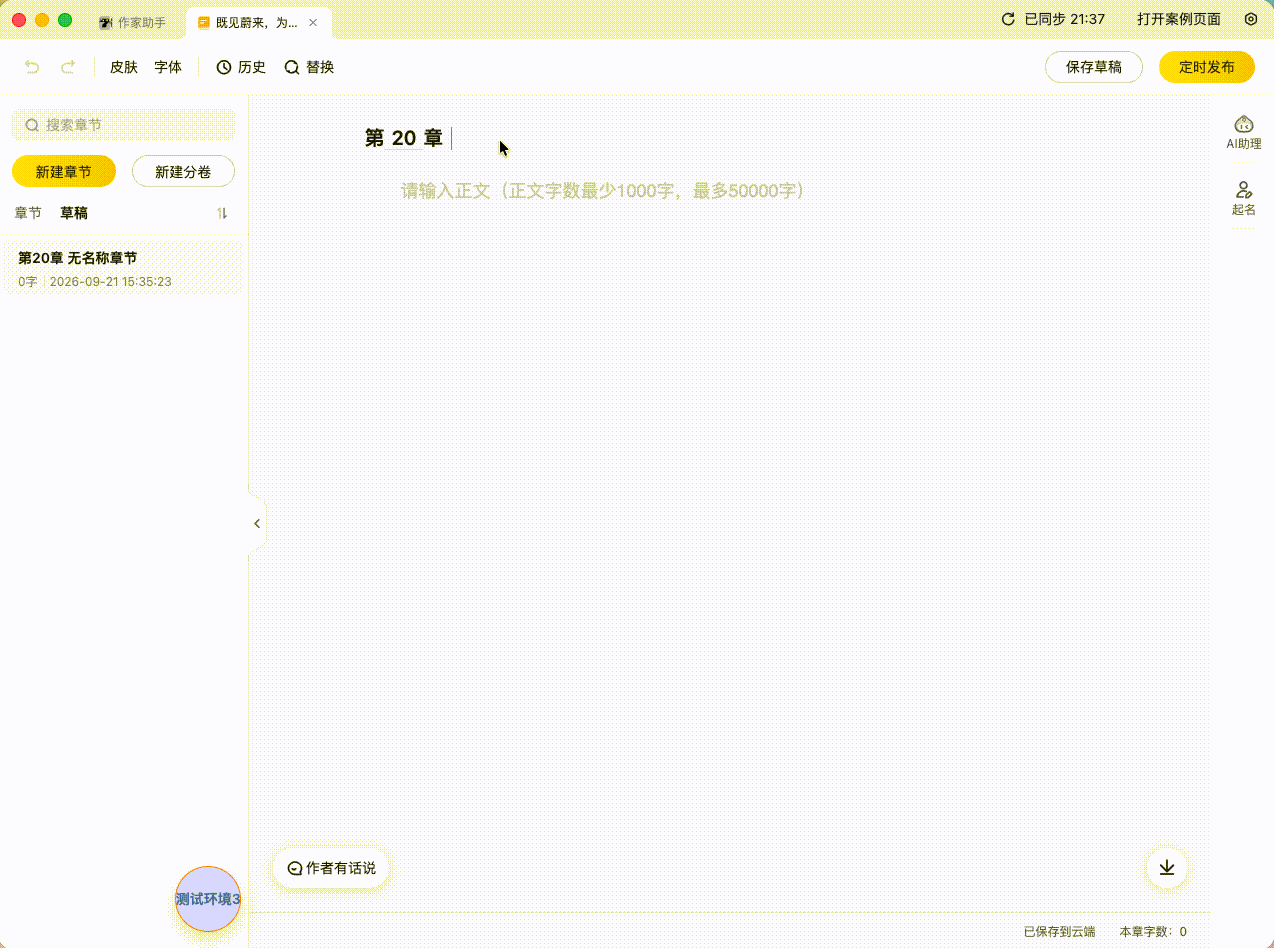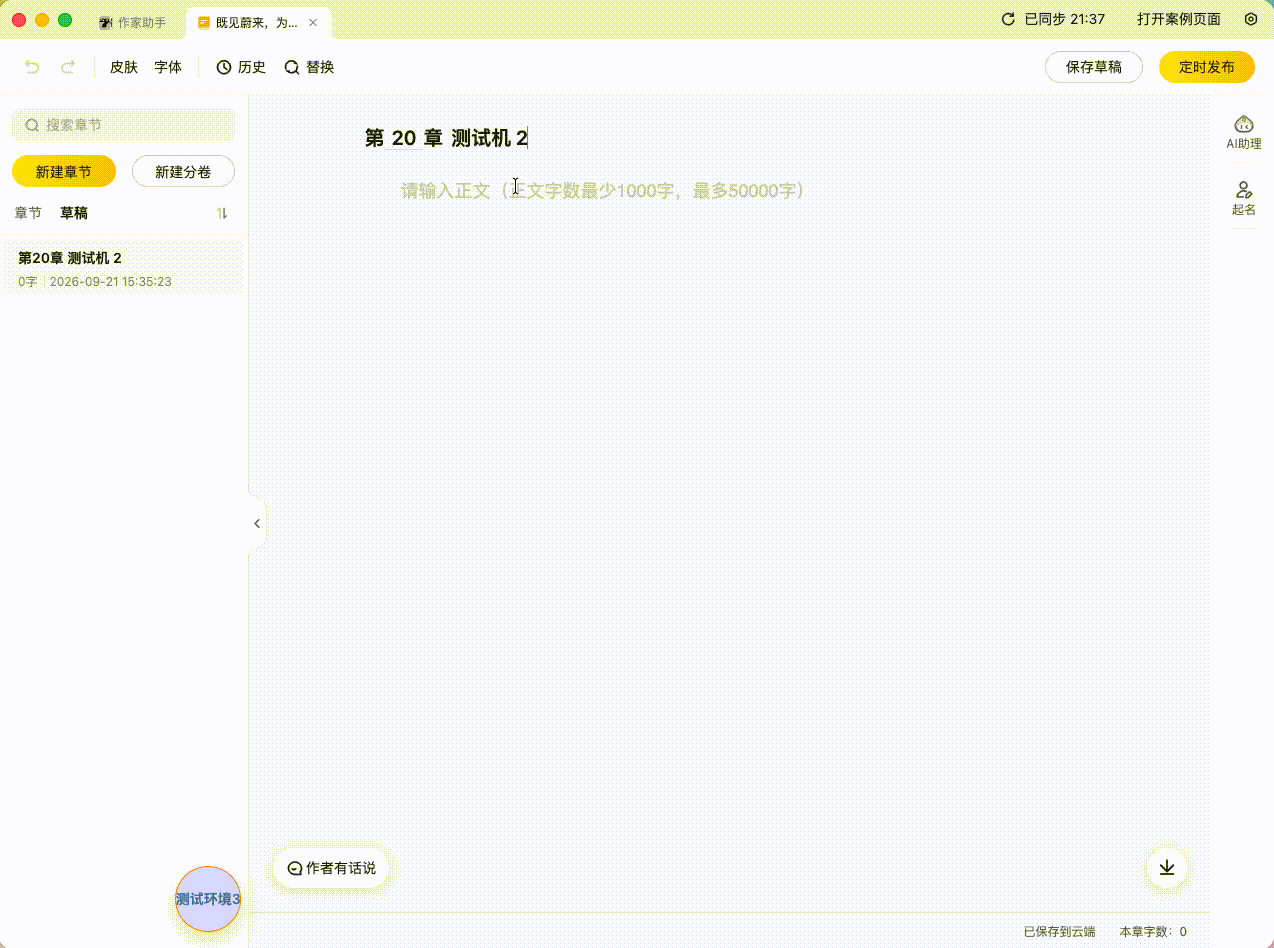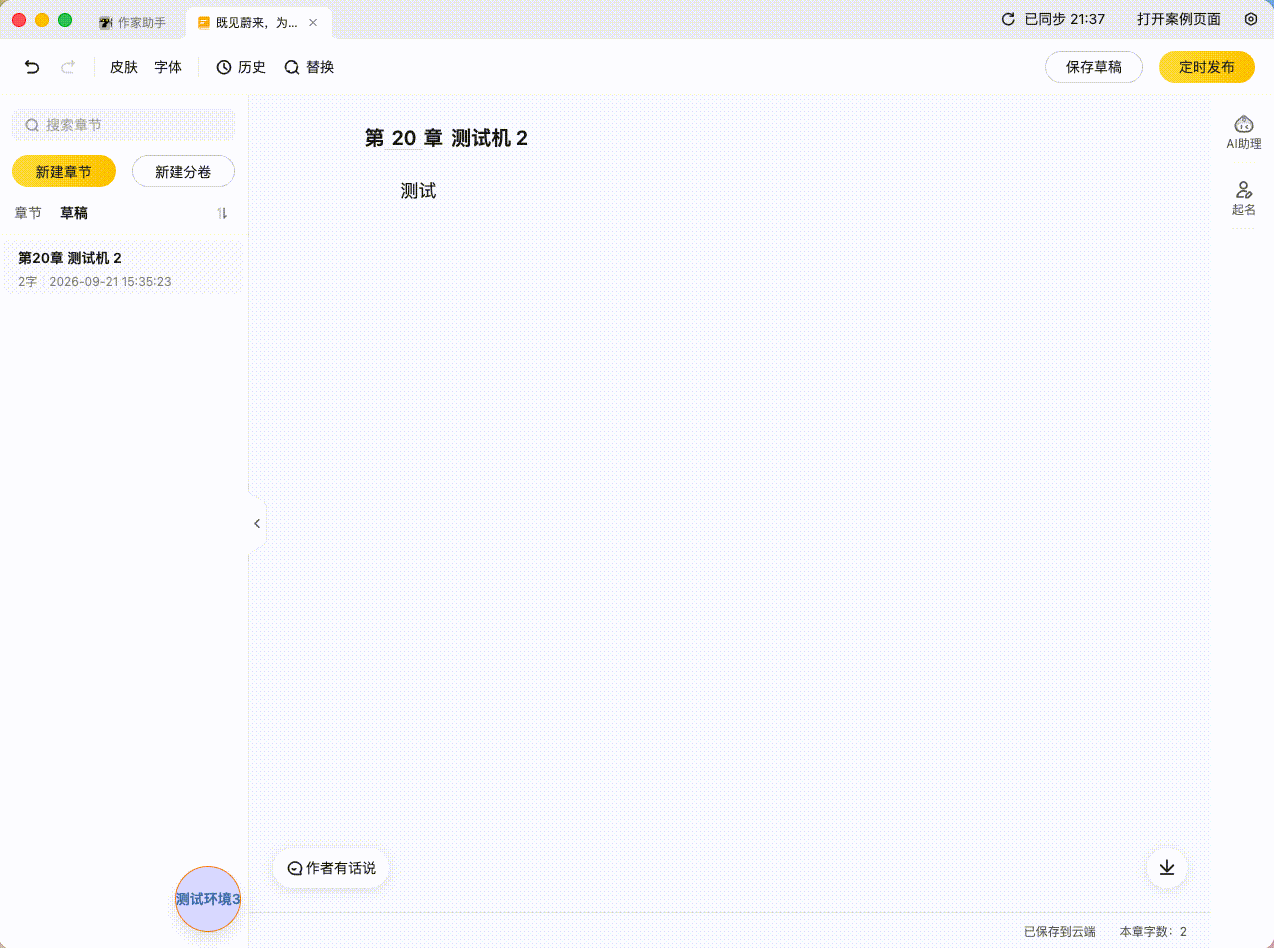
应用以作品为入口,在作品内部用卷和章节组织内容。作者从作品列表进入写作工作区,通过章节目录选择内容,在编辑区完成正文输入、修改和发布。
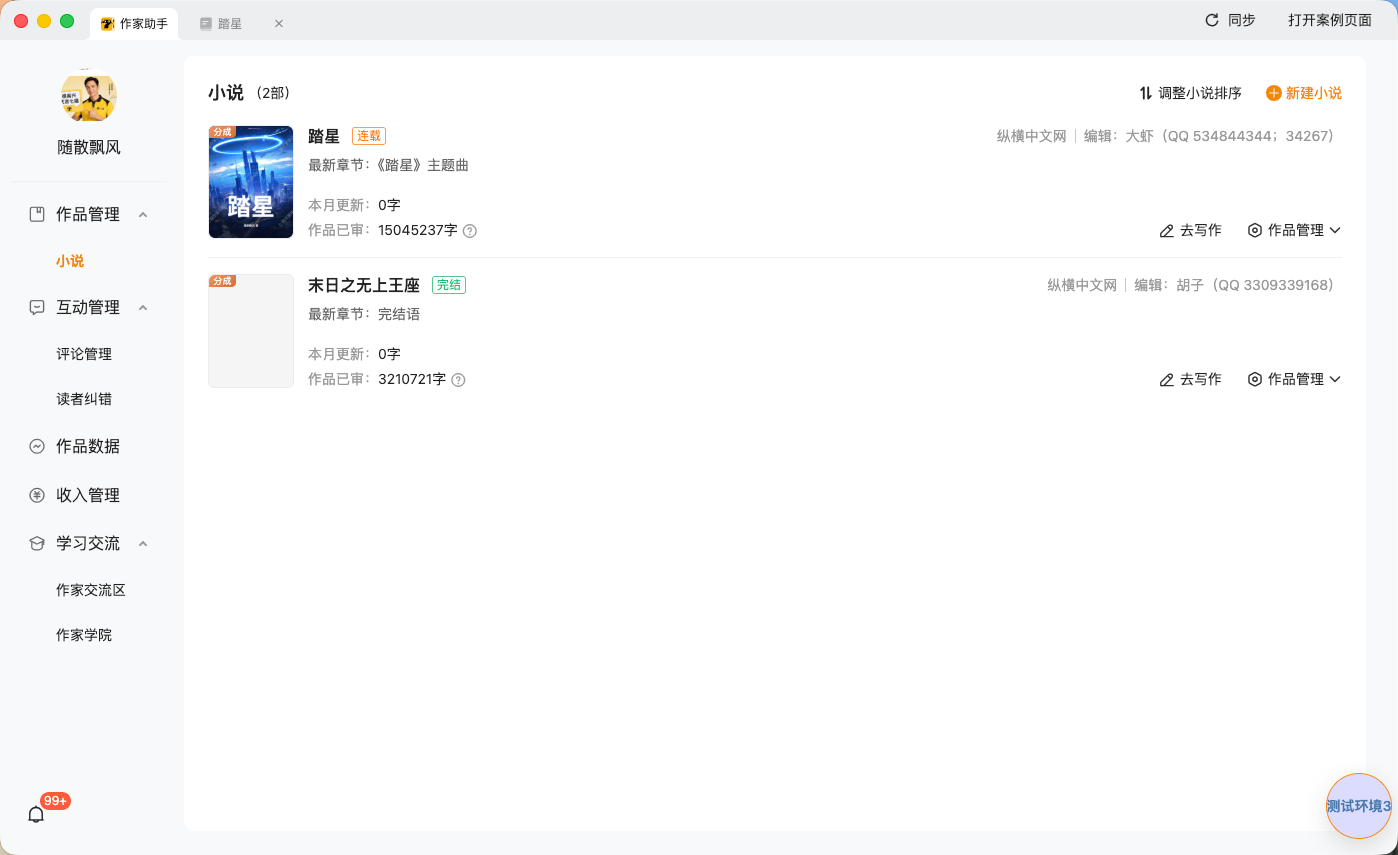
作品列表:从不同作品进入各自的写作工作区。
编辑区使用量子编辑器(QuantumEditor)处理正文输入,周围有章节目录、字数与保存状态、历史预览和查找替换等功能,右侧可以打开纠错或 AI 面板。作者写当前章节时,可以在这里查看作品相关信息,使用辅助工具。
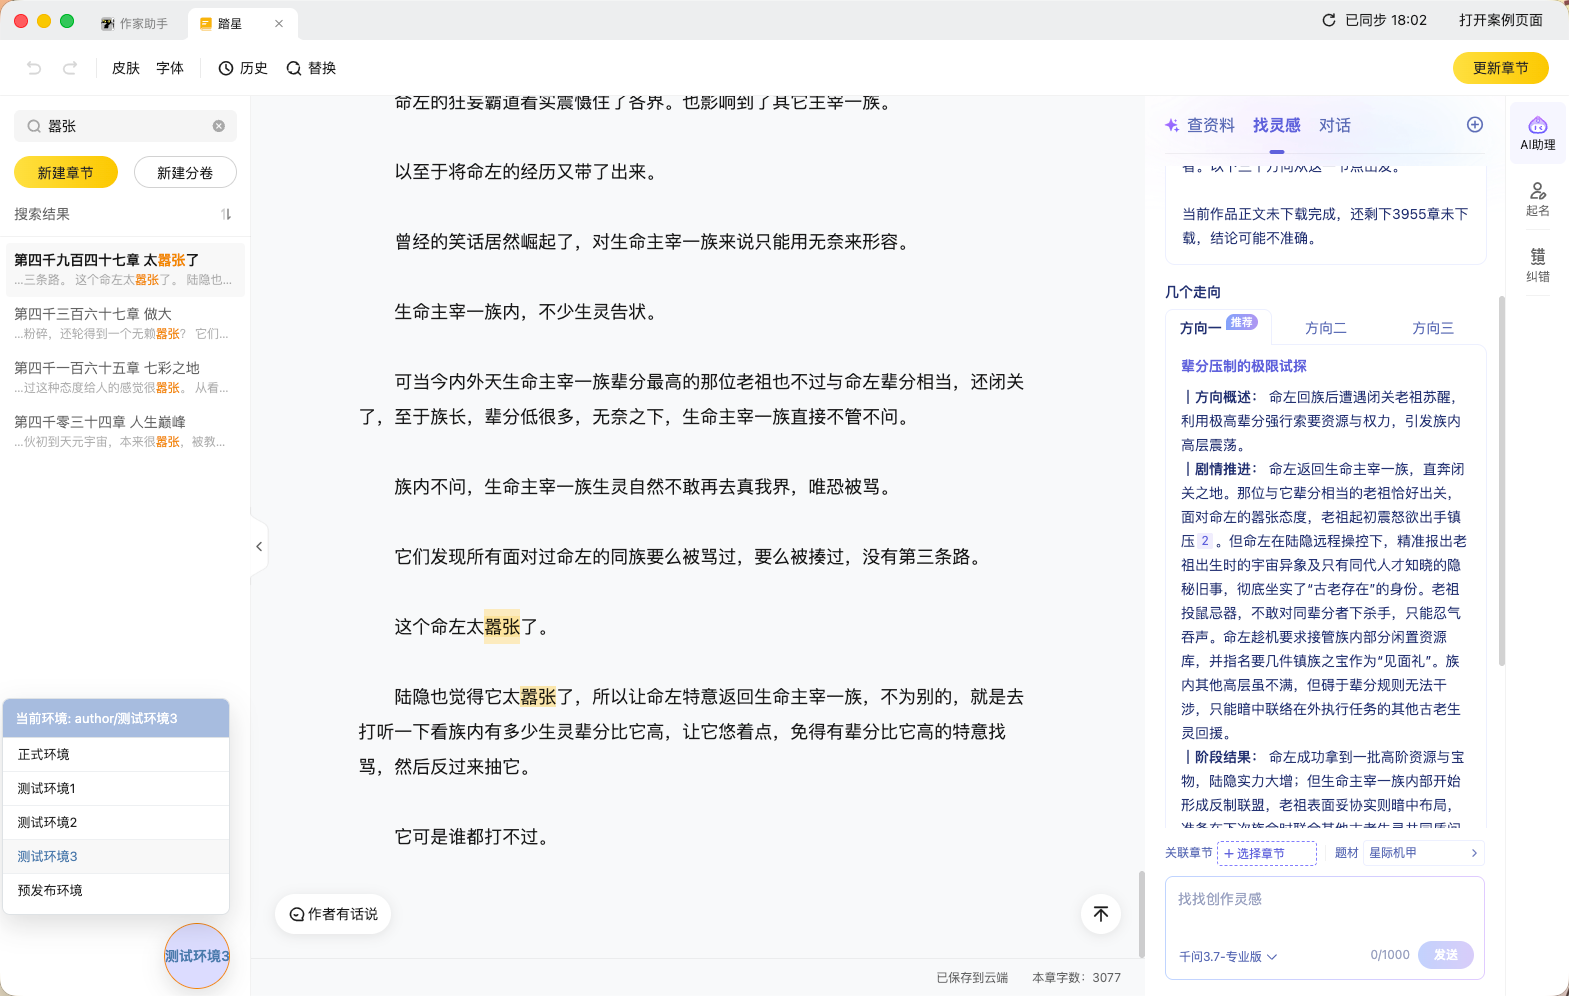
编辑工作区:目录、正文与辅助工具围绕当前作品展开
断网时,作者可以继续编辑本地已有的草稿,恢复网络后由同步服务处理待同步内容。搜索用于定位作品中的文字,AI 面板则提供查资料、找灵感和聊剧情等入口。
接下来从技术栈与运行架构,看这些写作功能如何协作。
技术栈
项目使用 Electron + Vue 3 + TypeScript:
- Vue 负责界面
- Electron 提供桌面运行环境
- TypeScript 用于页面、桌面服务和公共接口的开发
- 界面组件与样式复用 Ant Design Vue、Tailwind 和项目内的公共组件。
Electron 基础
桌面运行环境
Electron 是使用 JavaScript、HTML 和 CSS 开发桌面应用的框架。Chromium 提供页面渲染环境,Node.js 提供本地运行能力,Electron API 则提供窗口、菜单、文件对话框等系统接口。
项目因此可以沿用前端技术开发界面,在同一套 TypeScript 工程中实现桌面功能。代价是需要随应用分发运行时,增加安装包体积和内存开销,还要处理 Windows 与 macOS 在窗口、安装和更新方面的差异。
进程与通信
理解 Electron 的进程模型,可以先认识下面四个概念:
- Main(主进程):管理应用生命周期、窗口和系统能力,是桌面操作的协调入口。
- Renderer(渲染进程):运行 Vue 页面,负责界面展示、正文编辑和用户交互。
- Preload(预加载脚本):在页面加载前运行,通过受控接口向页面开放必要的桌面能力。它是桥接脚本,不是独立进程。
- IPC(进程间通信):让页面与主进程交换请求、结果和事件。
例如,页面需要打开文件对话框时,通过 Preload 暴露的接口发送请求,由 Main 调用系统能力,再把选择结果返回给页面。页面无需拿到完整的 Node.js 或文件系统权限,桌面入口也能统一检查请求参数与来源。
整体架构
进程分工
作家助手在 Electron 的基础上,将账号存储、搜索计算和 AI 运行放到独立进程中。页面负责交互,Main 协调业务请求,其他进程分别处理数据读写、检索计算和模型任务。
下图展示当前桌面版的主要业务进程,省略了 Electron 自身的 GPU 等辅助进程。
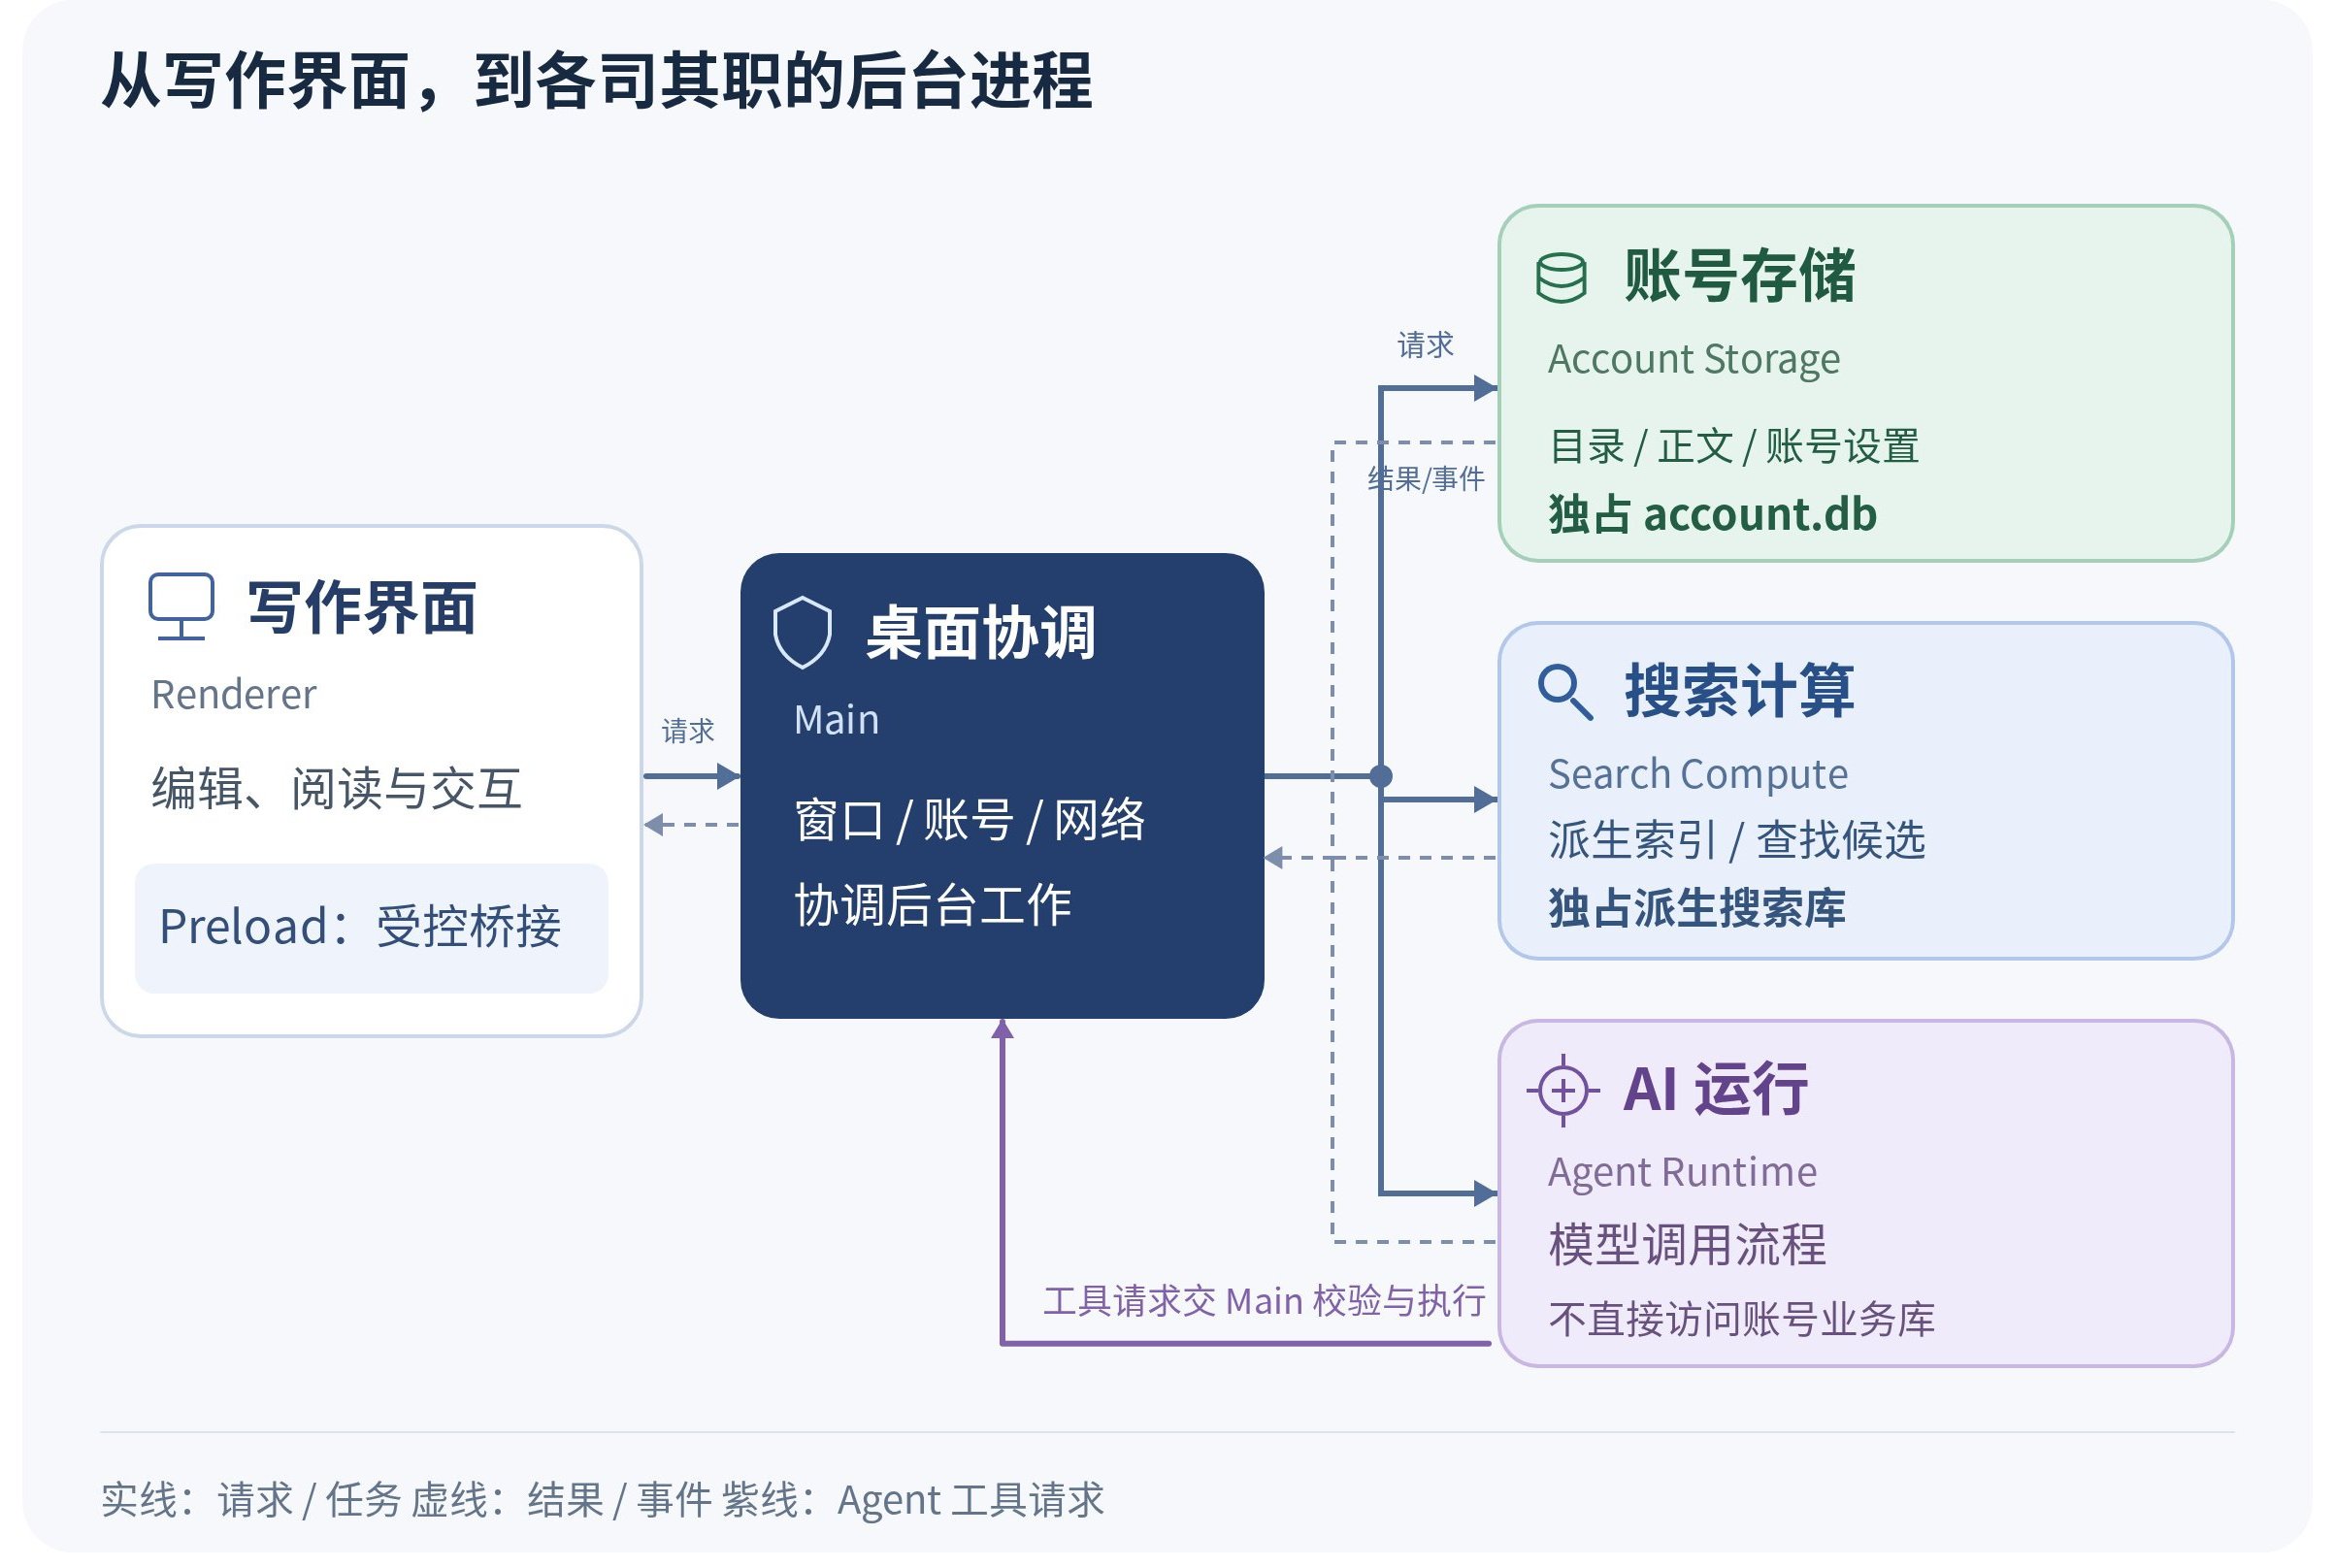
图 1|主要业务进程及通信关系。Main 协调请求、结果与事件;账号正文和派生索引分别由对应进程管理。
💻 Main 管理窗口、账号生命周期、登录凭证和网络请求。它接收页面操作,调用存储或计算接口,再把结果返回界面。
💾 Account Storage 独占账号业务数据库,保存作品目录、章节正文、必要历史与账号设置。其他模块通过具名读写接口访问数据,不各自打开账号库。
🔍 Search Compute 维护可从作品内容重新生成的搜索索引,并承担相关计算。原始稿件由存储进程保存,本地保存完成不需要等待索引更新。
🧠 Agent Runtime 执行 AI 任务,运行模型循环和工具调用流程。它通过 Main 的接口访问作品和受控网络,不直接打开业务数据库或管理账号凭证。
数据库操作、检索计算和模型任务分别在独立进程中执行,Main 负责应用协调。这样分工的目的是减少这些任务对写作交互的影响。
一次调用
假设本地已有作品内容,检索索引也可用。作者进入编辑器,在章节目录中输入“星河”发起文本检索。下图按进入编辑器、执行检索两个阶段展示调用过程。
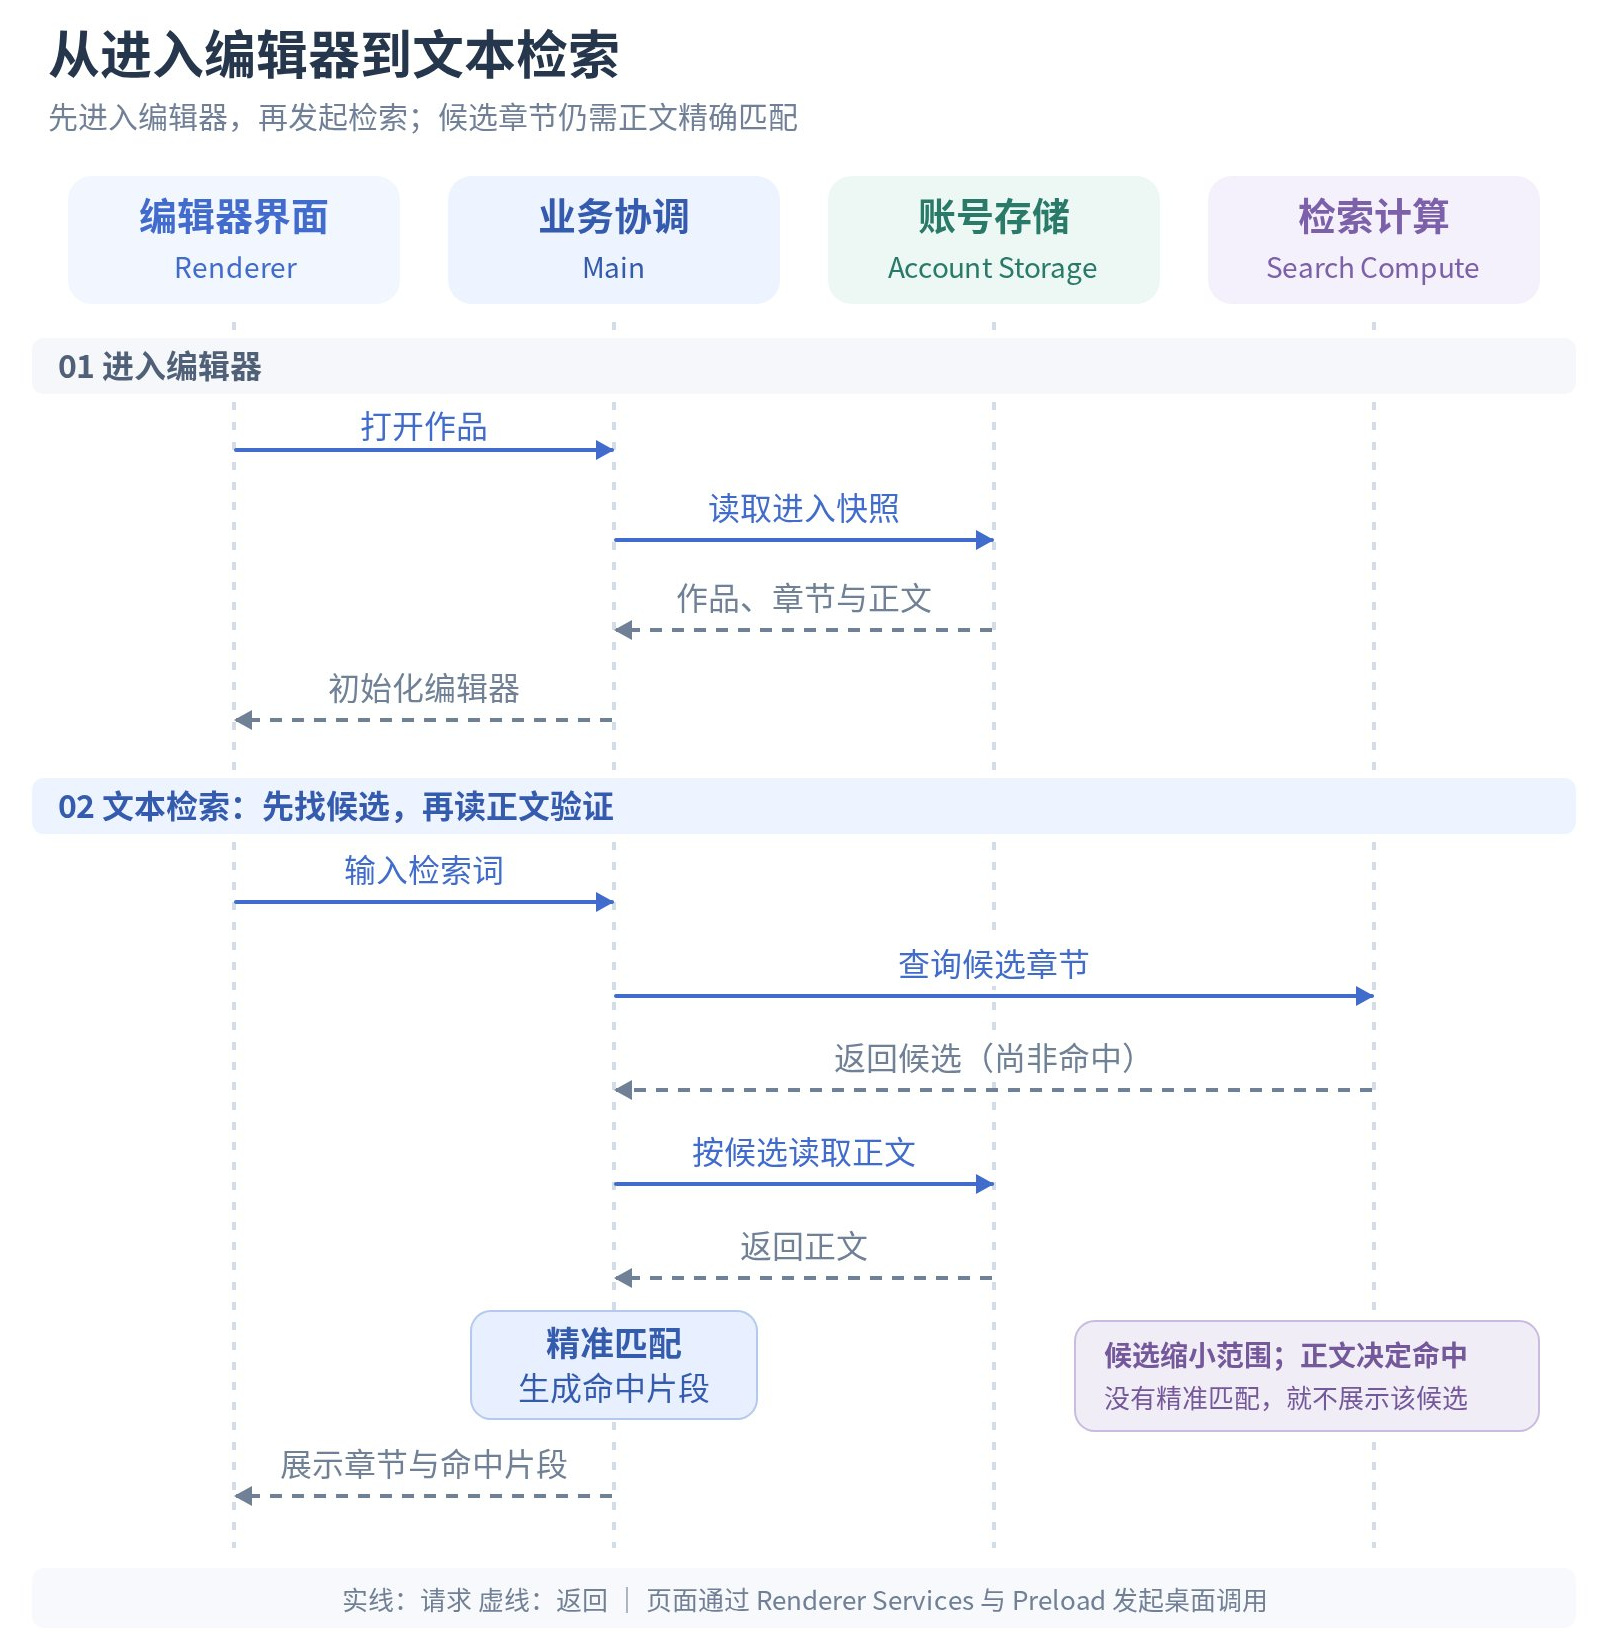
图 2|从进入编辑器到文本检索。候选章节仍需读取正文、精准匹配,才能生成最终命中片段。
页面通过 Renderer Services 与 Preload 使用桌面能力,两者不单独列为进程。检索时,Search Compute 负责候选召回,Account Storage 提供正文,Main 完成精准匹配并生成命中片段,最后由界面展示结果。索引更新、分页和异常处理将在后续篇章中展开。
边界与成本
进程隔离让账号数据和派生任务有了清晰的所有者,但通信本身也有成本。跨进程请求需要序列化、参数校验与消息传递;多个进程仍共享 CPU、磁盘和内存带宽,后台任务并不等于没有资源竞争。
项目将正文保存与派生索引分开,让保存不等待索引更新;大段正文通过受控、有界的接口传递,避免无限扩大的单条消息。与此同时,Main 仍承担产品编排、网络回调和文本精准匹配,Renderer 也仍可能受到编辑器计算与排版影响。拆进程降低耦合,却不能单凭架构图保证输入、切章或搜索耗时。
评估这套取舍,需要同时观察作品规模、打开的 Tab、后台同步与索引任务,以及各进程的 CPU、内存和 I/O。本文解释运行边界,不把分层本身当作性能实测结论。
工程结构
应用壳与公共包
应用壳负责启动和装配,公共包提供可复用的实现。当前构建与发布使用 modern;legacy 保留兼容入口,不代表已经交付与 modern 相同的 Worker 能力。
💡 代码包与进程并非一一对应。例如,Core 中的代码会被 Main、Preload 或 Worker 入口使用,Renderer Services 则运行在页面侧。查找实现时,需要同时看目录归属和运行入口。
图 3|应用壳负责装配,公共包提供实现;框体表示代码归属。当前发布、兼容入口与规划方向分别标注。
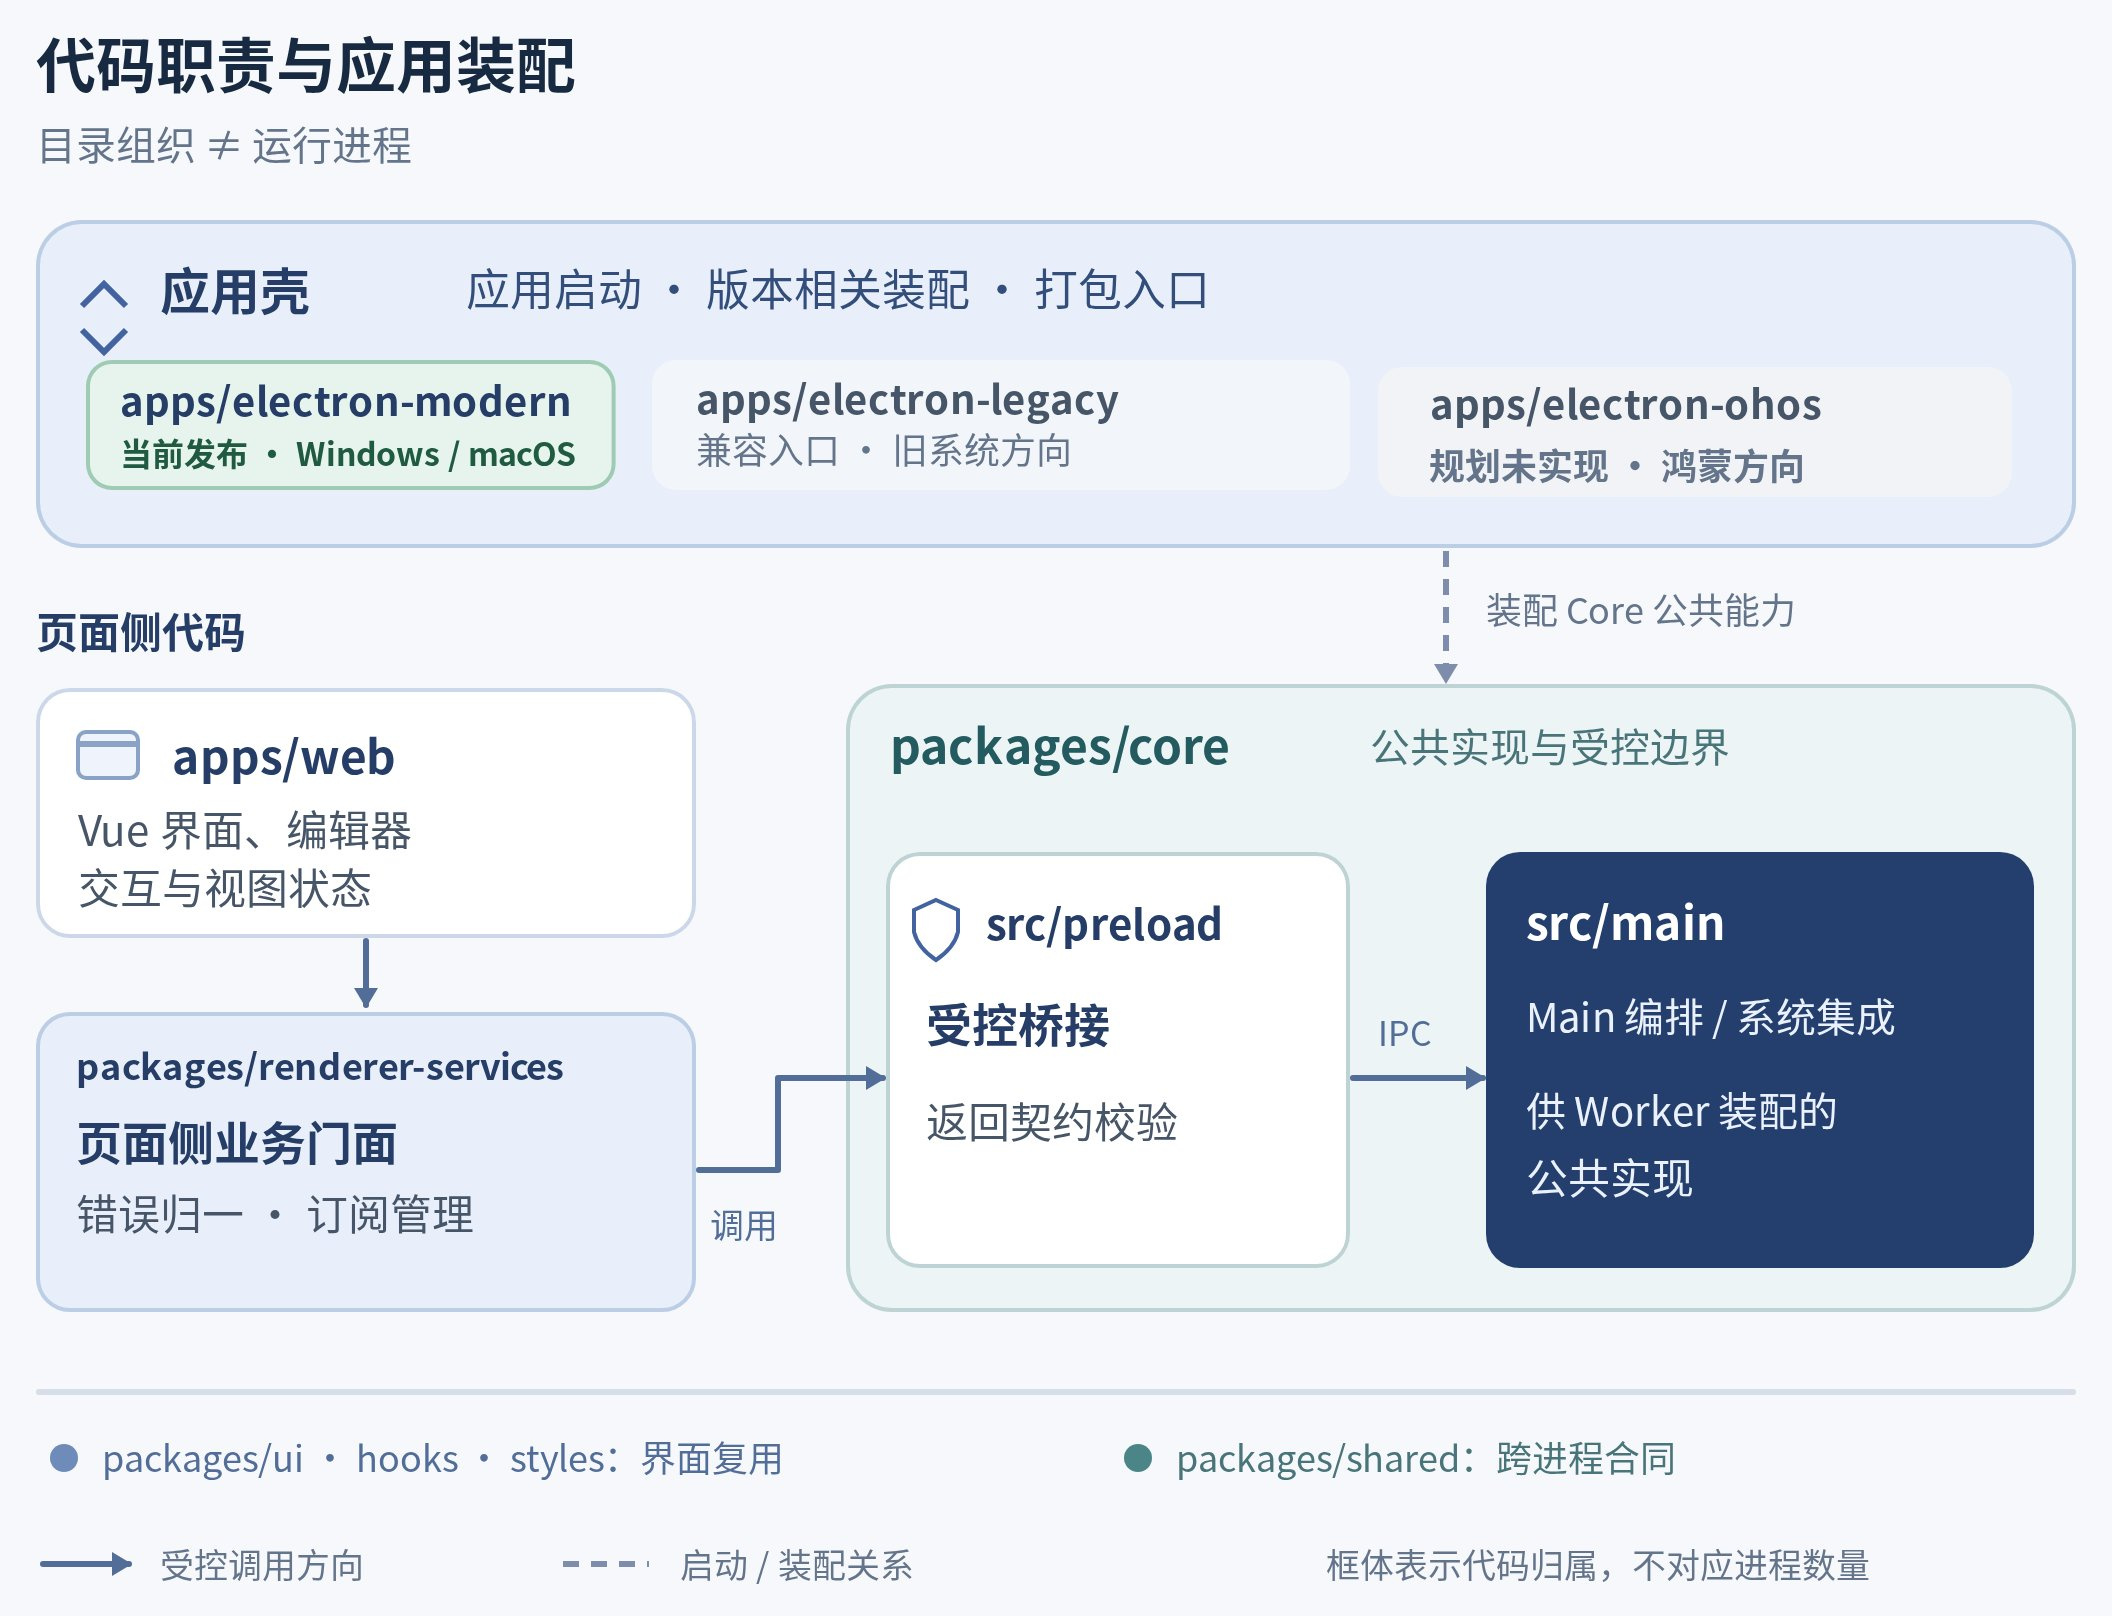
一次跨层功能修改通常会同时涉及多个位置:Shared 定义数据约定,Core 实现桌面业务,Renderer Services 提供页面入口,Vue 页面使用结果。按这一分工,组件可以通过服务入口使用桌面功能,避免直接依赖 IPC 通道、数据库连接或窗口实例。
沿一次保存读代码
理解目录后,可以从页面向下追一次章节保存。先在 Renderer Services 找到页面调用的方法和结果类型,再看 Preload 与 IPC 如何转交请求,然后进入 Core 的章节产品服务,观察它如何区分草稿与已发布章。
继续往下,Account Storage 的章节模块定义了正文与元数据的提交边界;book/sync 中的工作器负责远端上传和结果结算。读到这里,就能把“保存按钮”与后文的事务、revision 和同步状态一一对应。
💡 **按调用关系阅读:**Renderer Services → Preload/IPC → Main 章节服务 → Storage 保存事务 → Main 同步工作器 → Storage 条件确认。
网络请求位于本地事务之外,页面通过服务结果和状态事件获得反馈。
包管理与构建
pnpm workspace
管理依赖与仓库内公共包关系,让应用壳、业务实现和共享组件能在同一工程中引用。
Turborepo
按任务依赖编排构建与检查,并复用缓存;具体编译仍由 Vite、Rollup 等工具完成。
跨包类型正确并不意味着上游产物已经准备好。构建和检查需要遵循依赖顺序,先生成被引用的公共包产物,再验证下游应用。运行时分工和工程构建分工分别解决不同的问题。
主要模块
编辑与窗口
作品和章节管理提供内容结构,量子编辑器负责正文输入与插件交互。页面通过 EditorSession(编辑器会话)组织当前章节、编辑状态和保存操作,目录、工具条与状态栏共用这份编辑状态。
TabManager 和 WindowManager 管理页面创建、复用、显示与焦点。主窗口内的 Tab 各自拥有 WebContents,即 Electron 承载页面内容的实例。同一作品只保留一个编辑器会话,再次打开时复用已有页面;不同作品可以分别打开。
账号与数据
Main 管理登录凭证和账号生命周期,账号产品会话将相关业务服务绑定到对应的 Storage。账号设置保存在账号库中,机器级偏好由独立的设置模块管理。
存储模块提交本地稿件和业务状态,同步服务负责与云端交换数据。本地保存和远端确认有各自的完成条件。后面的“本地保存”“云端同步”和“冲突与恢复”将沿一次编辑过程解释它们如何协作。
搜索与 AI
Main、Storage 和 Search Compute 共同完成作品内容的搜索。AI 功能由页面面板、Main 宿主和 Agent Runtime 组成:面板展示对话,宿主提供业务工具,运行时执行模型任务。第二篇介绍 AI 运行链路,第三篇介绍作品资产生成以及作品检索、读取和引用。
公共能力
网络、快捷键、更新和日志通过统一入口供业务使用。Core 组织公共模块的注册、启动与释放,独立 Worker 保留各自的通信协议和生命周期。
本地保存
作者保存草稿后,文字先落到哪里?先看图中的绿色提交节点:它确认本机正文已保存,云端同步与搜索索引随后分别追赶。已发布或定时章节的显式更新有不同顺序,见后文“保存入口的不同语义”。
一段文字怎样落盘
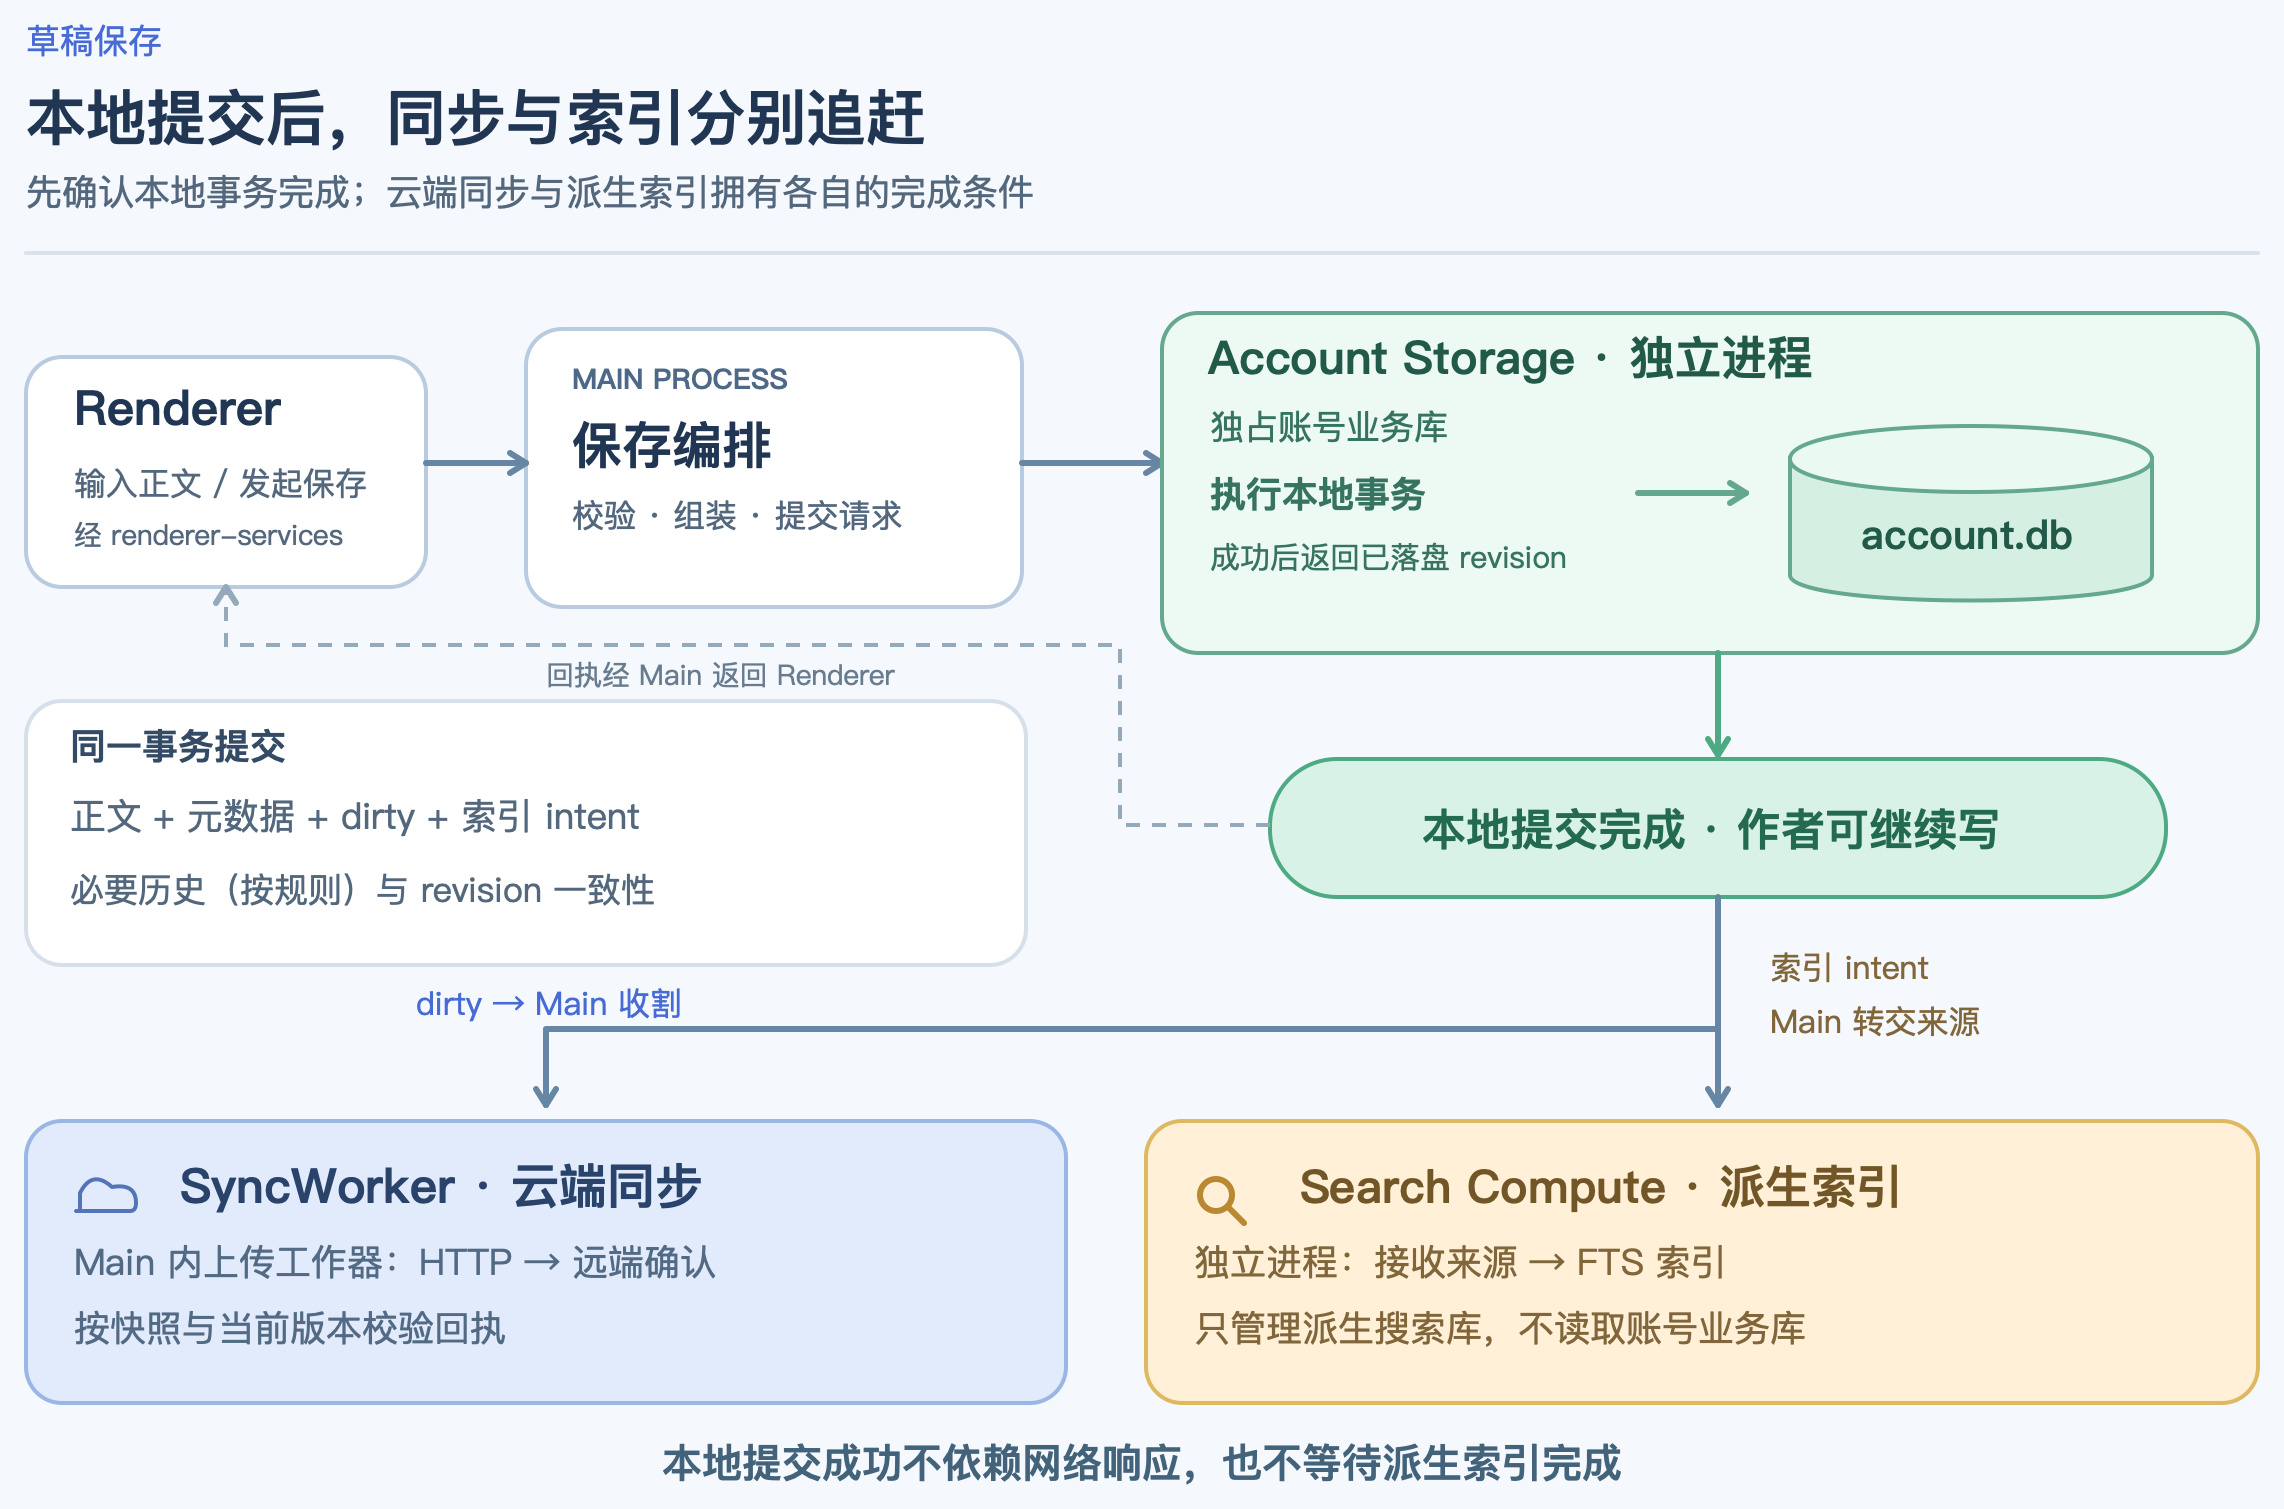
图 4|草稿的本地事务提交是本地保存完成点;dirty 与索引 intent 分别驱动上传和派生索引追赶。提交回执经 Main 返回页面。
页面经 Renderer Services、Preload 提交请求,Main 校验来源和账号,Storage 再校验章节身份与 revision。正文、元数据、dirty 和索引 intent 在同一事务中提交,避免正文更新后丢失待同步标记。历史按规则处理,可选自动历史失败有独立反馈。
正文与索引各自完成
建立索引的目的是为了加快全文搜索功能,以及 AI 正文检索 + 分数排名
💾 本地正文 · 事实
Storage 提交后才算本地保存成功。提交失败时保留作者输入,并明确反馈。
🔍 搜索索引 · 派生结果
Search Compute 经 Main 获得来源并更新索引。索引可以滞后,不能代替正文事实。
索引 intent 记录需要追赶的变更,不是远端上传队列。Search Compute 不直接连接账号库;产品全文搜索的精准匹配与 AI 排名检索也有不同的结果语义。
提交了,回执却没到
事务成功和调用方收到回执是两个时刻。当前连接可以查询内存请求结果;连接关闭、结果淘汰或进程重启后,结果可能无法查明。
💡 unknown 表示回执无法查明,不表示正文未保存。
恢复时结合当前章节事实和业务规则核对,不据此自动重放创建、删除等非幂等操作。
云端同步
本地提交之后,章节的 dirty 状态成为待同步事实。离线期间多次修改同一章,不需要为每次输入保存一条持久化上传任务;同步服务读取章节当前状态,再取得与该 revision 对应的正文快照。
同步工作的分工
**SyncWorker 仍运行在 Main 中。**名字里的 Worker 表示工作器,不意味着独立操作系统进程。它负责 dirty 章节的 PUSH:经 Storage 收集待同步章节,读取稳定快照,在事务外执行网络请求,再经 Storage 条件式采用远端结果。
完整同步还包括其他职责。BookSyncOrchestrator 管理当前打开作品的同步上下文,协调目录刷新、当前所需正文拉取和可选预取;目录校准与冲突服务处理远端事实采用和冲突落地。它们需要写入账号数据时,都经过 Storage。把这些工作都塞进 SyncWorker,会让上传执行器同时承担过多业务判断。
同一账号的 PUSH 串行执行,重复唤醒会被合并。网络等待不占用正文事务,作者仍可以继续编辑和保存。在线手动保存可以等待当前章指定 revision 的确认,但不会抢占在途 HTTP,也不会因此启动全账号收割。
远端成功只确认一次快照
假设作者保存后,上传还没完成,又输入了一段新文字。服务端稍后返回成功,到底确认了哪一份内容?下面用 A、B 表示两个先后提交的本地版本,只作讲解编号;当前实现以章节 updated_at 作为递增的本地 revision,并与服务端 version 分开校验。
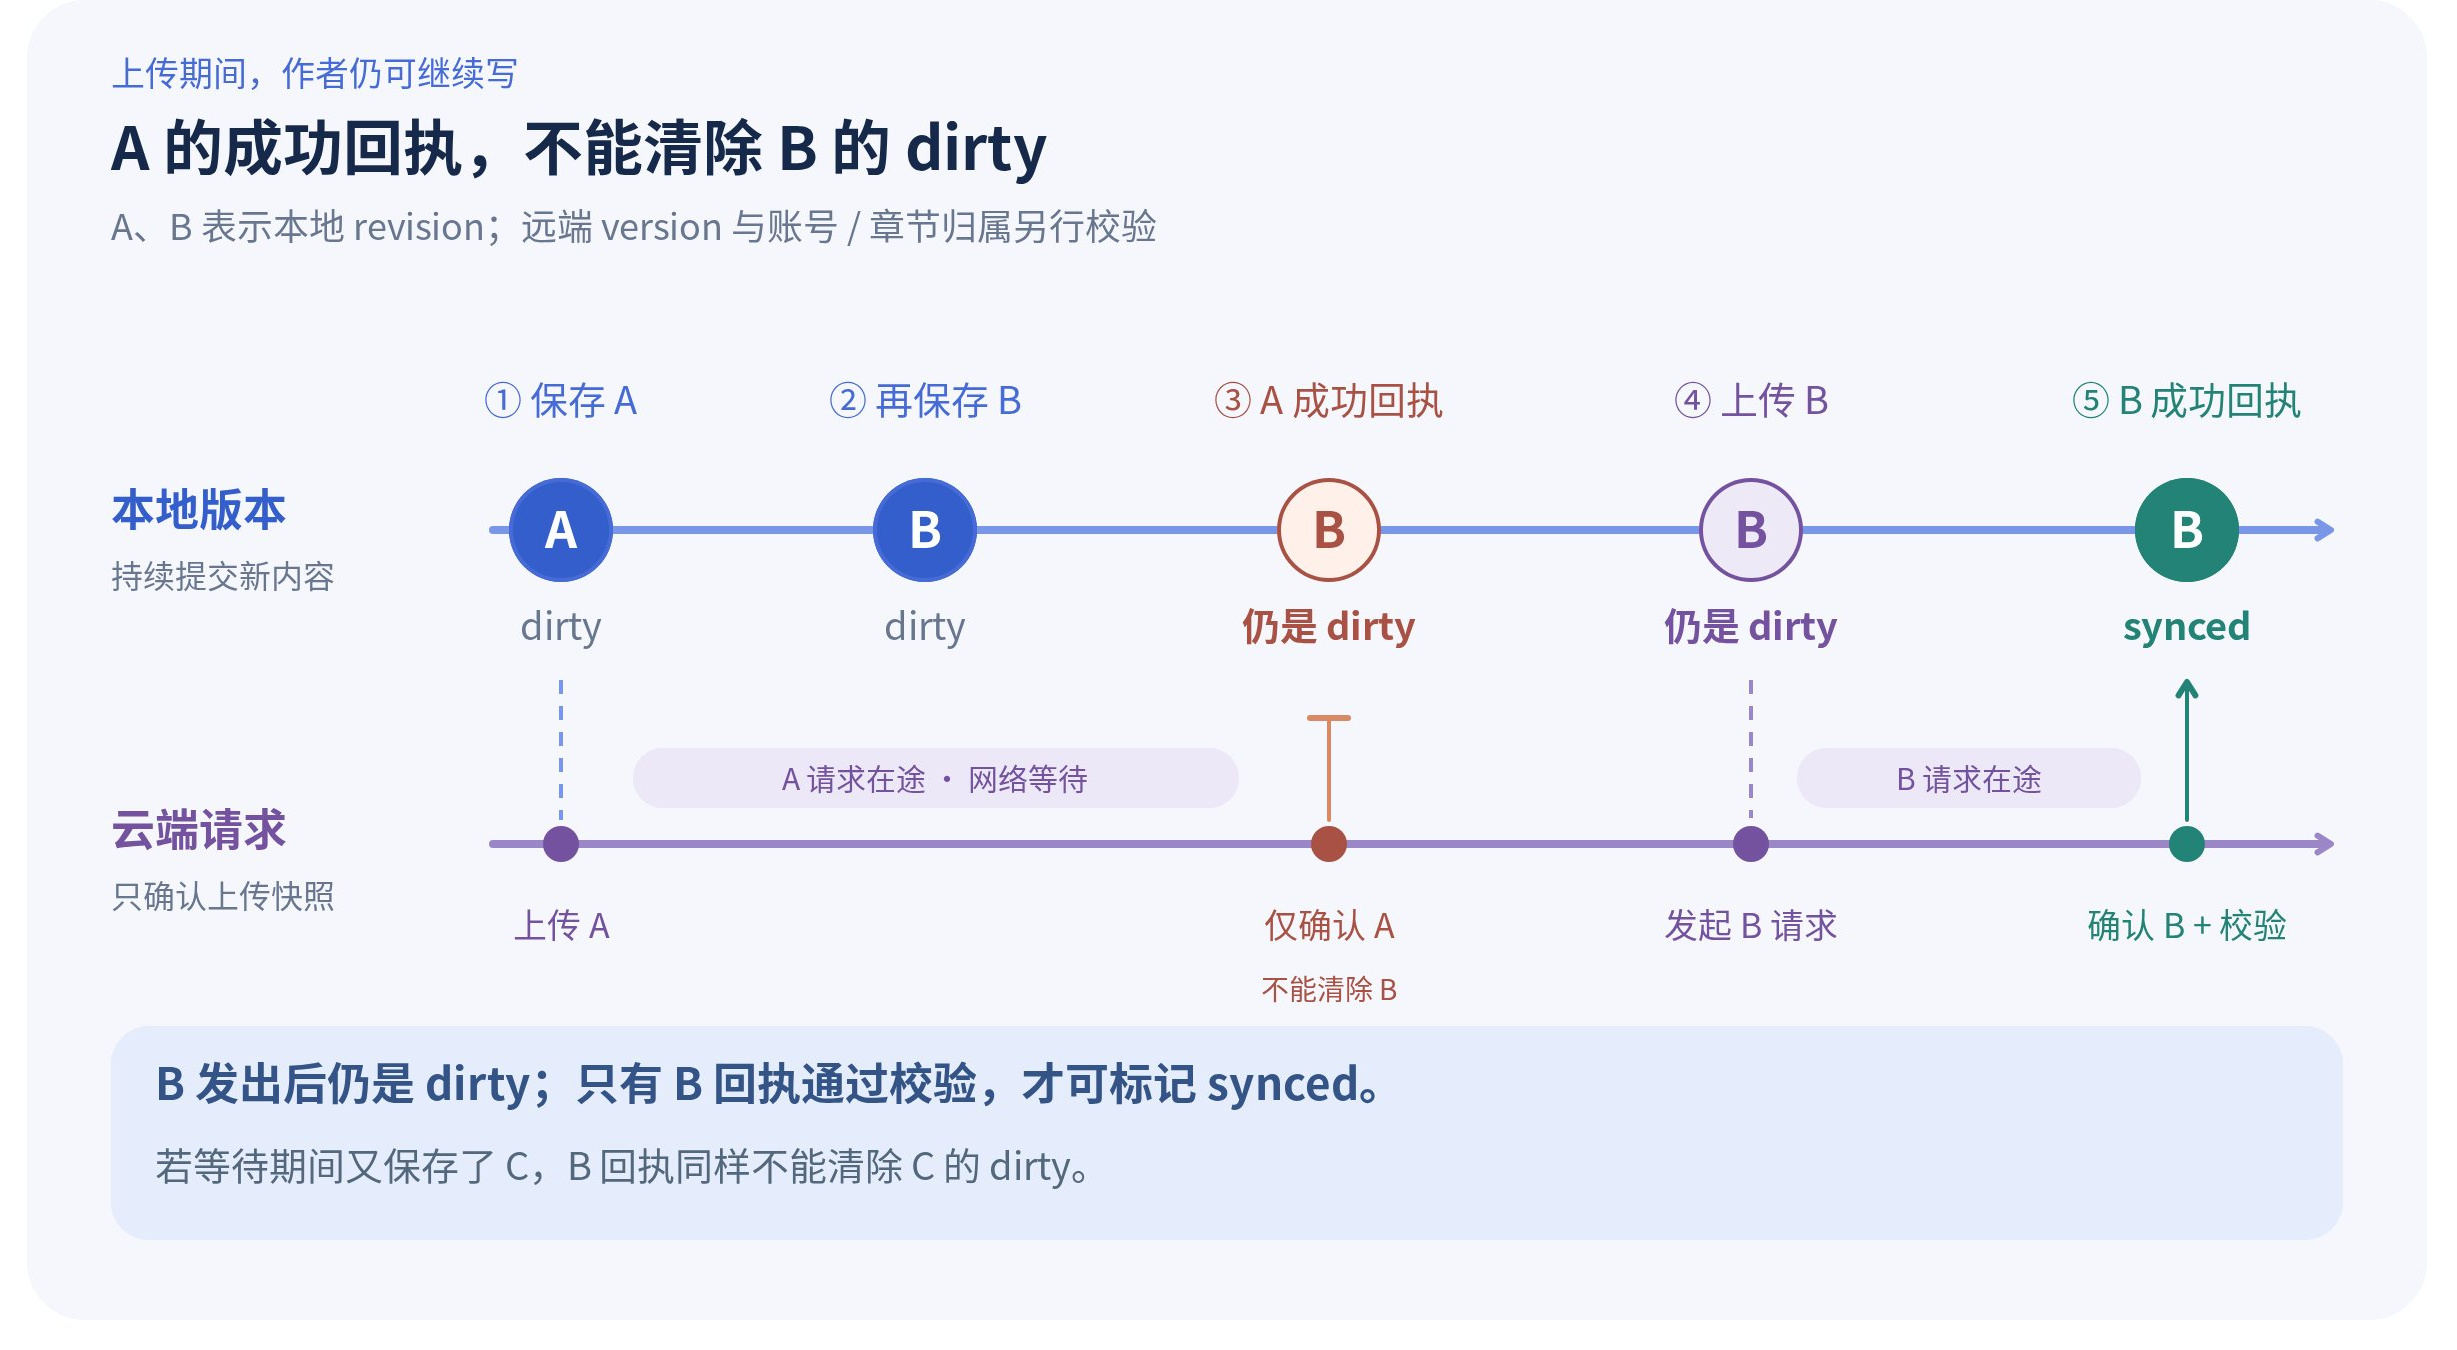
图 5|编辑与网络请求并行推进。A 的成功回执不能清除 B 的 dirty;上传 B 后仍须等待 B 的成功回执,并通过当前事实校验。
远端成功是真的,但只对应请求开始时的快照。Storage 采用结果时还会检查 revision、章节归属、远端身份和删除状态。若本地已经变化,旧回执不能清掉新内容的 dirty,也不能把新编辑展示成已上传。
保存入口的不同语义
同一个保存按钮背后,草稿与已发布章节有不同约束。草稿先保护输入;已发布或定时章节的显式更新,需要先获得远端确认,再写入本地基线。
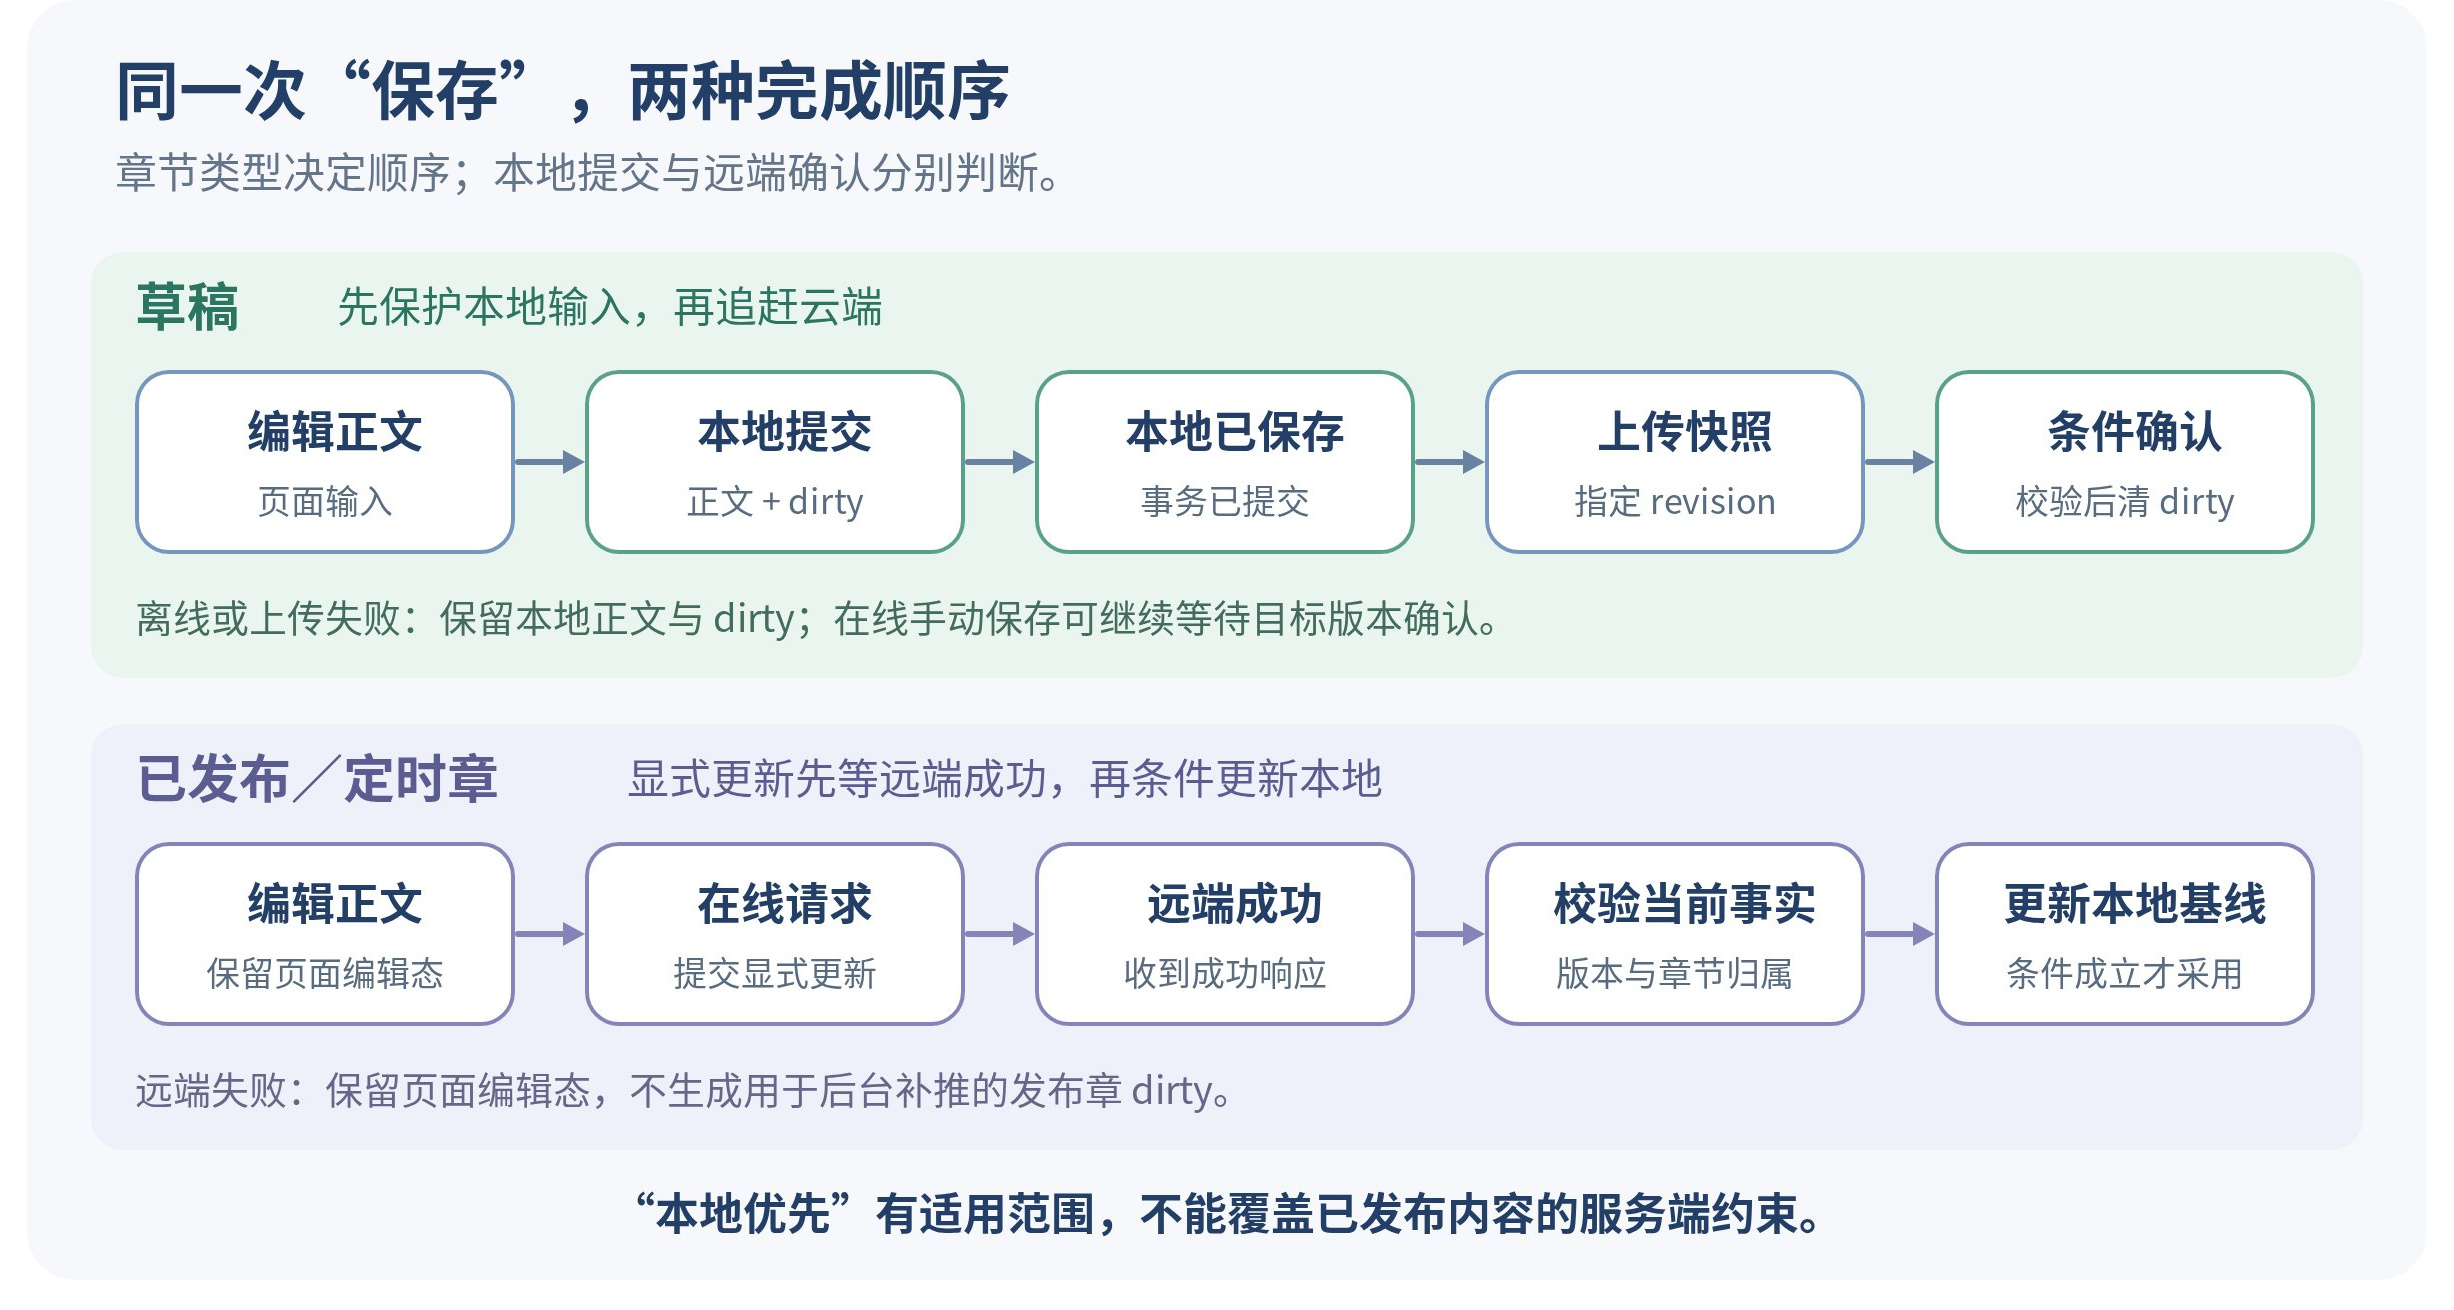
图 6|草稿先完成本地提交;已发布/定时章的显式更新先获得远端成功,再条件更新本地基线。两条路径的失败处理不同。
| 入口 | 本地与远端的顺序 | 失败或变化时 |
|---|---|---|
| 草稿自动保存 | 先完成本地提交,远端同步在后台处理。 | 离线或远端失败保留 dirty,本地结果不因此撤销。 |
| 草稿手动保存 | 先本地提交;在线时等待当前章指定 revision 的远端确认。 | 区分本地结果与远端结果;新编辑取代目标版本时保留待同步事实。 |
| 退出 flush | 按退出流程保护草稿最后内容,不等待远端 HTTP。 | 冲突章按规则保存历史;已发布章另行分流,不能一律按草稿覆盖。 |
| 已发布/定时章更新 | 在线请求成功后,才条件式更新本地正文和基线。 | 远端失败时保留编辑器页面态,不制造可后台补推的发布章 dirty。 |
本地新建且还没有远端 chapter_id 的草稿,也先保存到本机,随后由上传流程补齐远端映射。删除则遵循另一条边界:已上云章节先经远端确认,再删除本地;未上云的本地草稿可以直接在本地删除。“本地优先”不能被理解为所有写操作都跳过服务端约束。
冲突与恢复
一次网络失败可能改变界面提示,但不会撤销已经提交的正文。理解冲突与恢复,先把数据库里的事实与此刻的界面反馈分开。
事实与界面状态
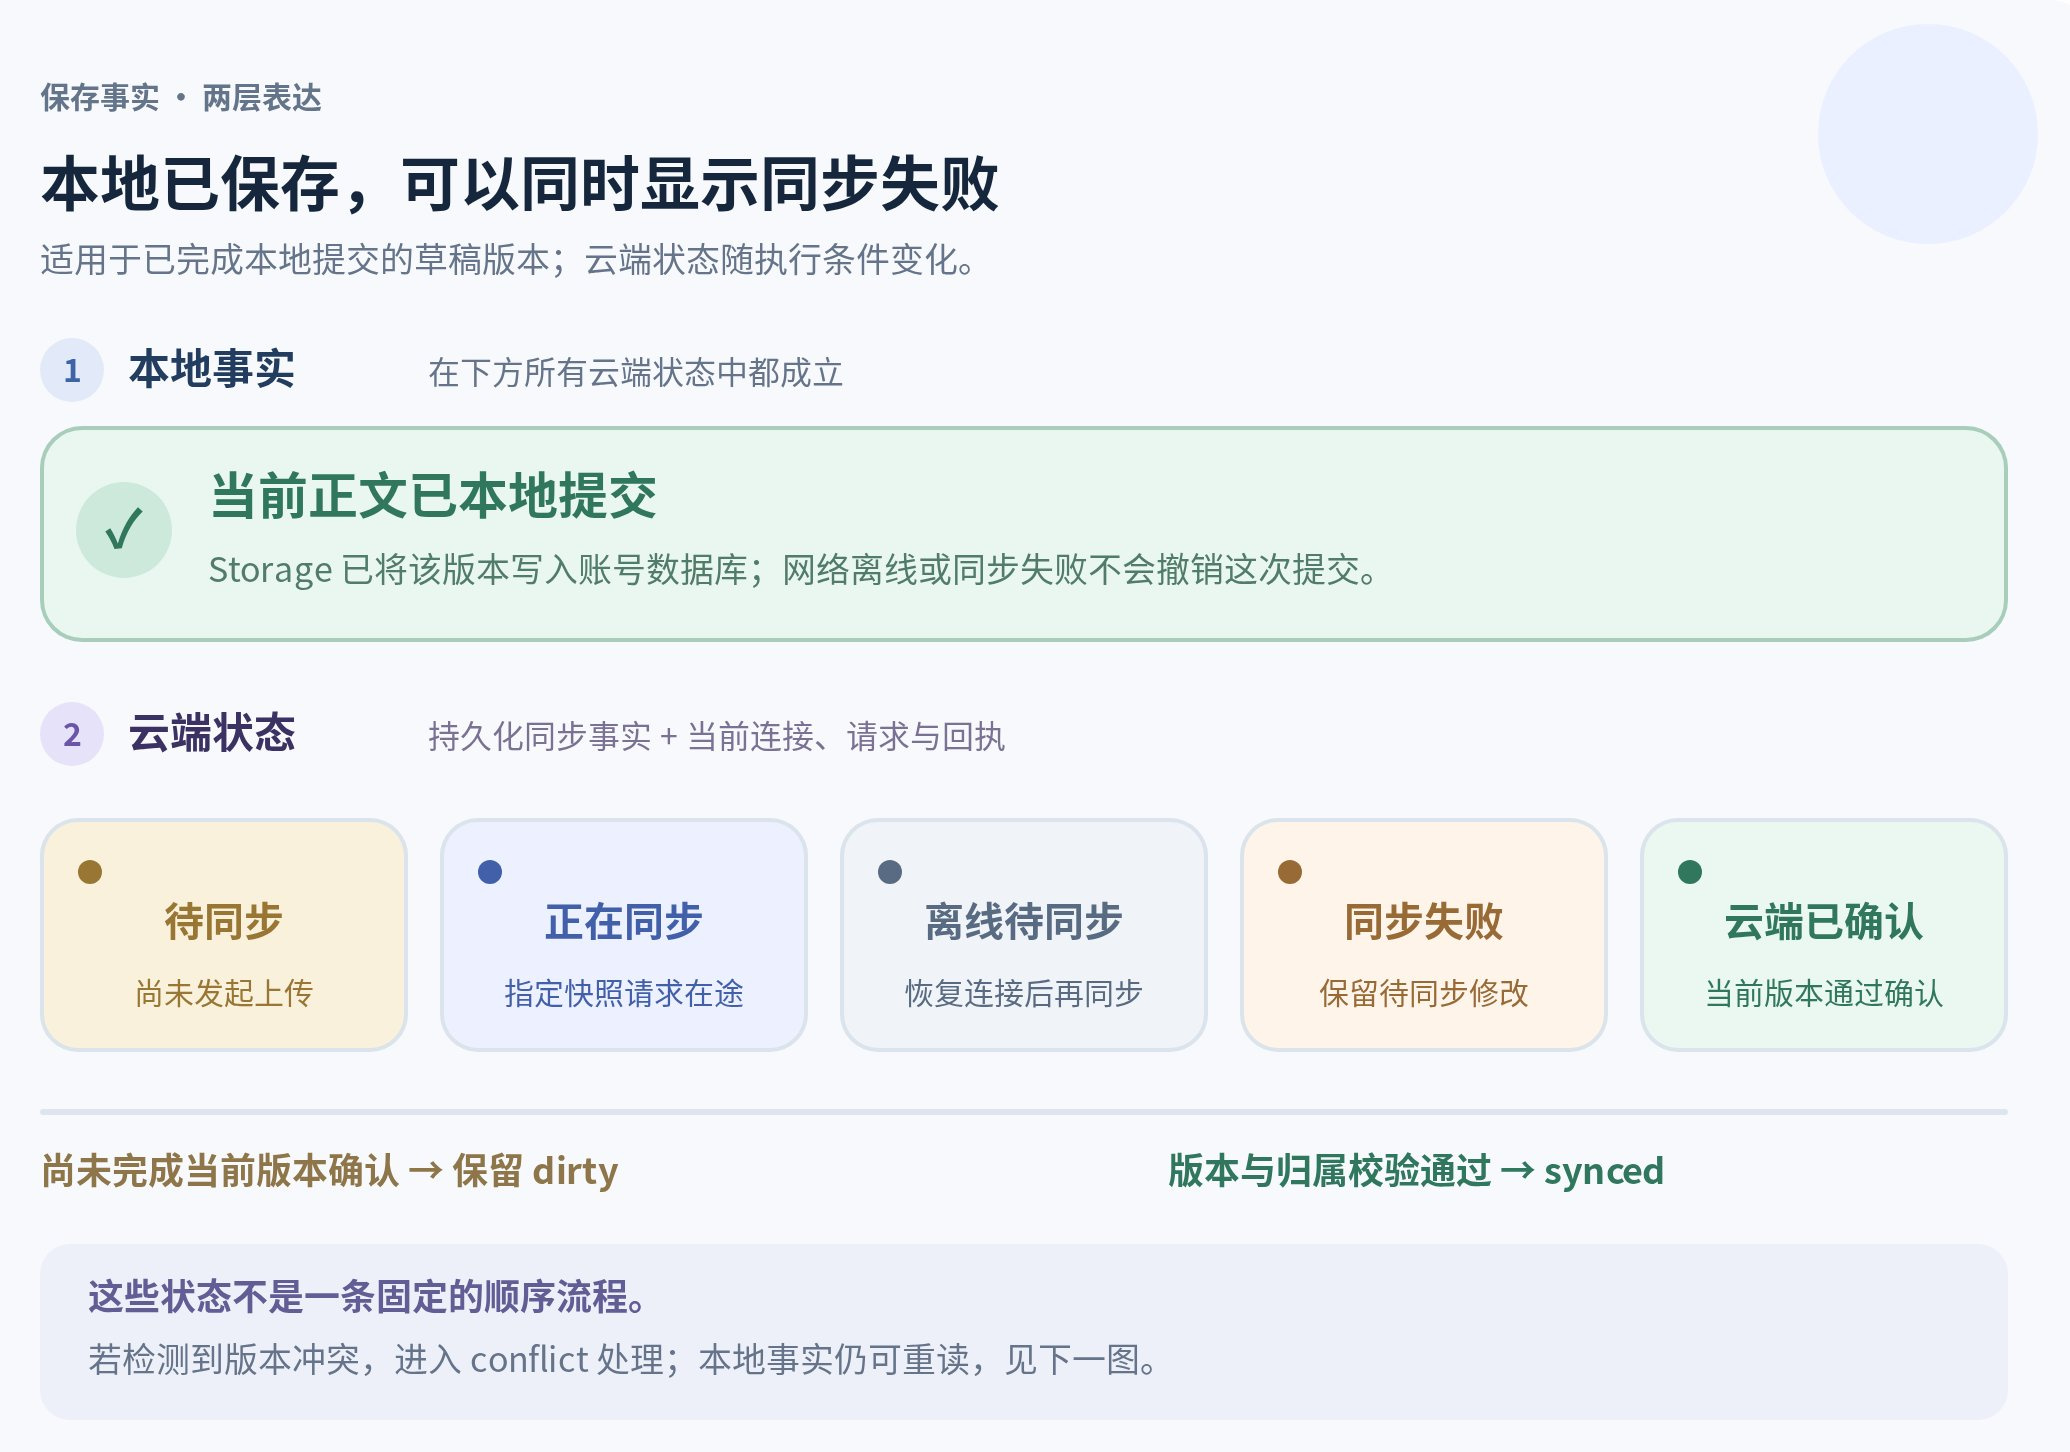
图 7|本地保存结果与云端同步状态分别表达。同步中、离线或同步失败,都不会撤销已经提交的本地正文。
SQLite 的 sync_status 只保留 synced、dirty、conflict。Main 结合网络、工作器活动与持久化状态生成反馈,所以界面可以同时表达“本地已保存”和“云端尚未确认”。
丢失后仍能恢复
冲突先持久化,再通知当前页面。若页面恰好关闭,重新打开后仍从 Storage 读取冲突事实,继续进入对比与裁决。
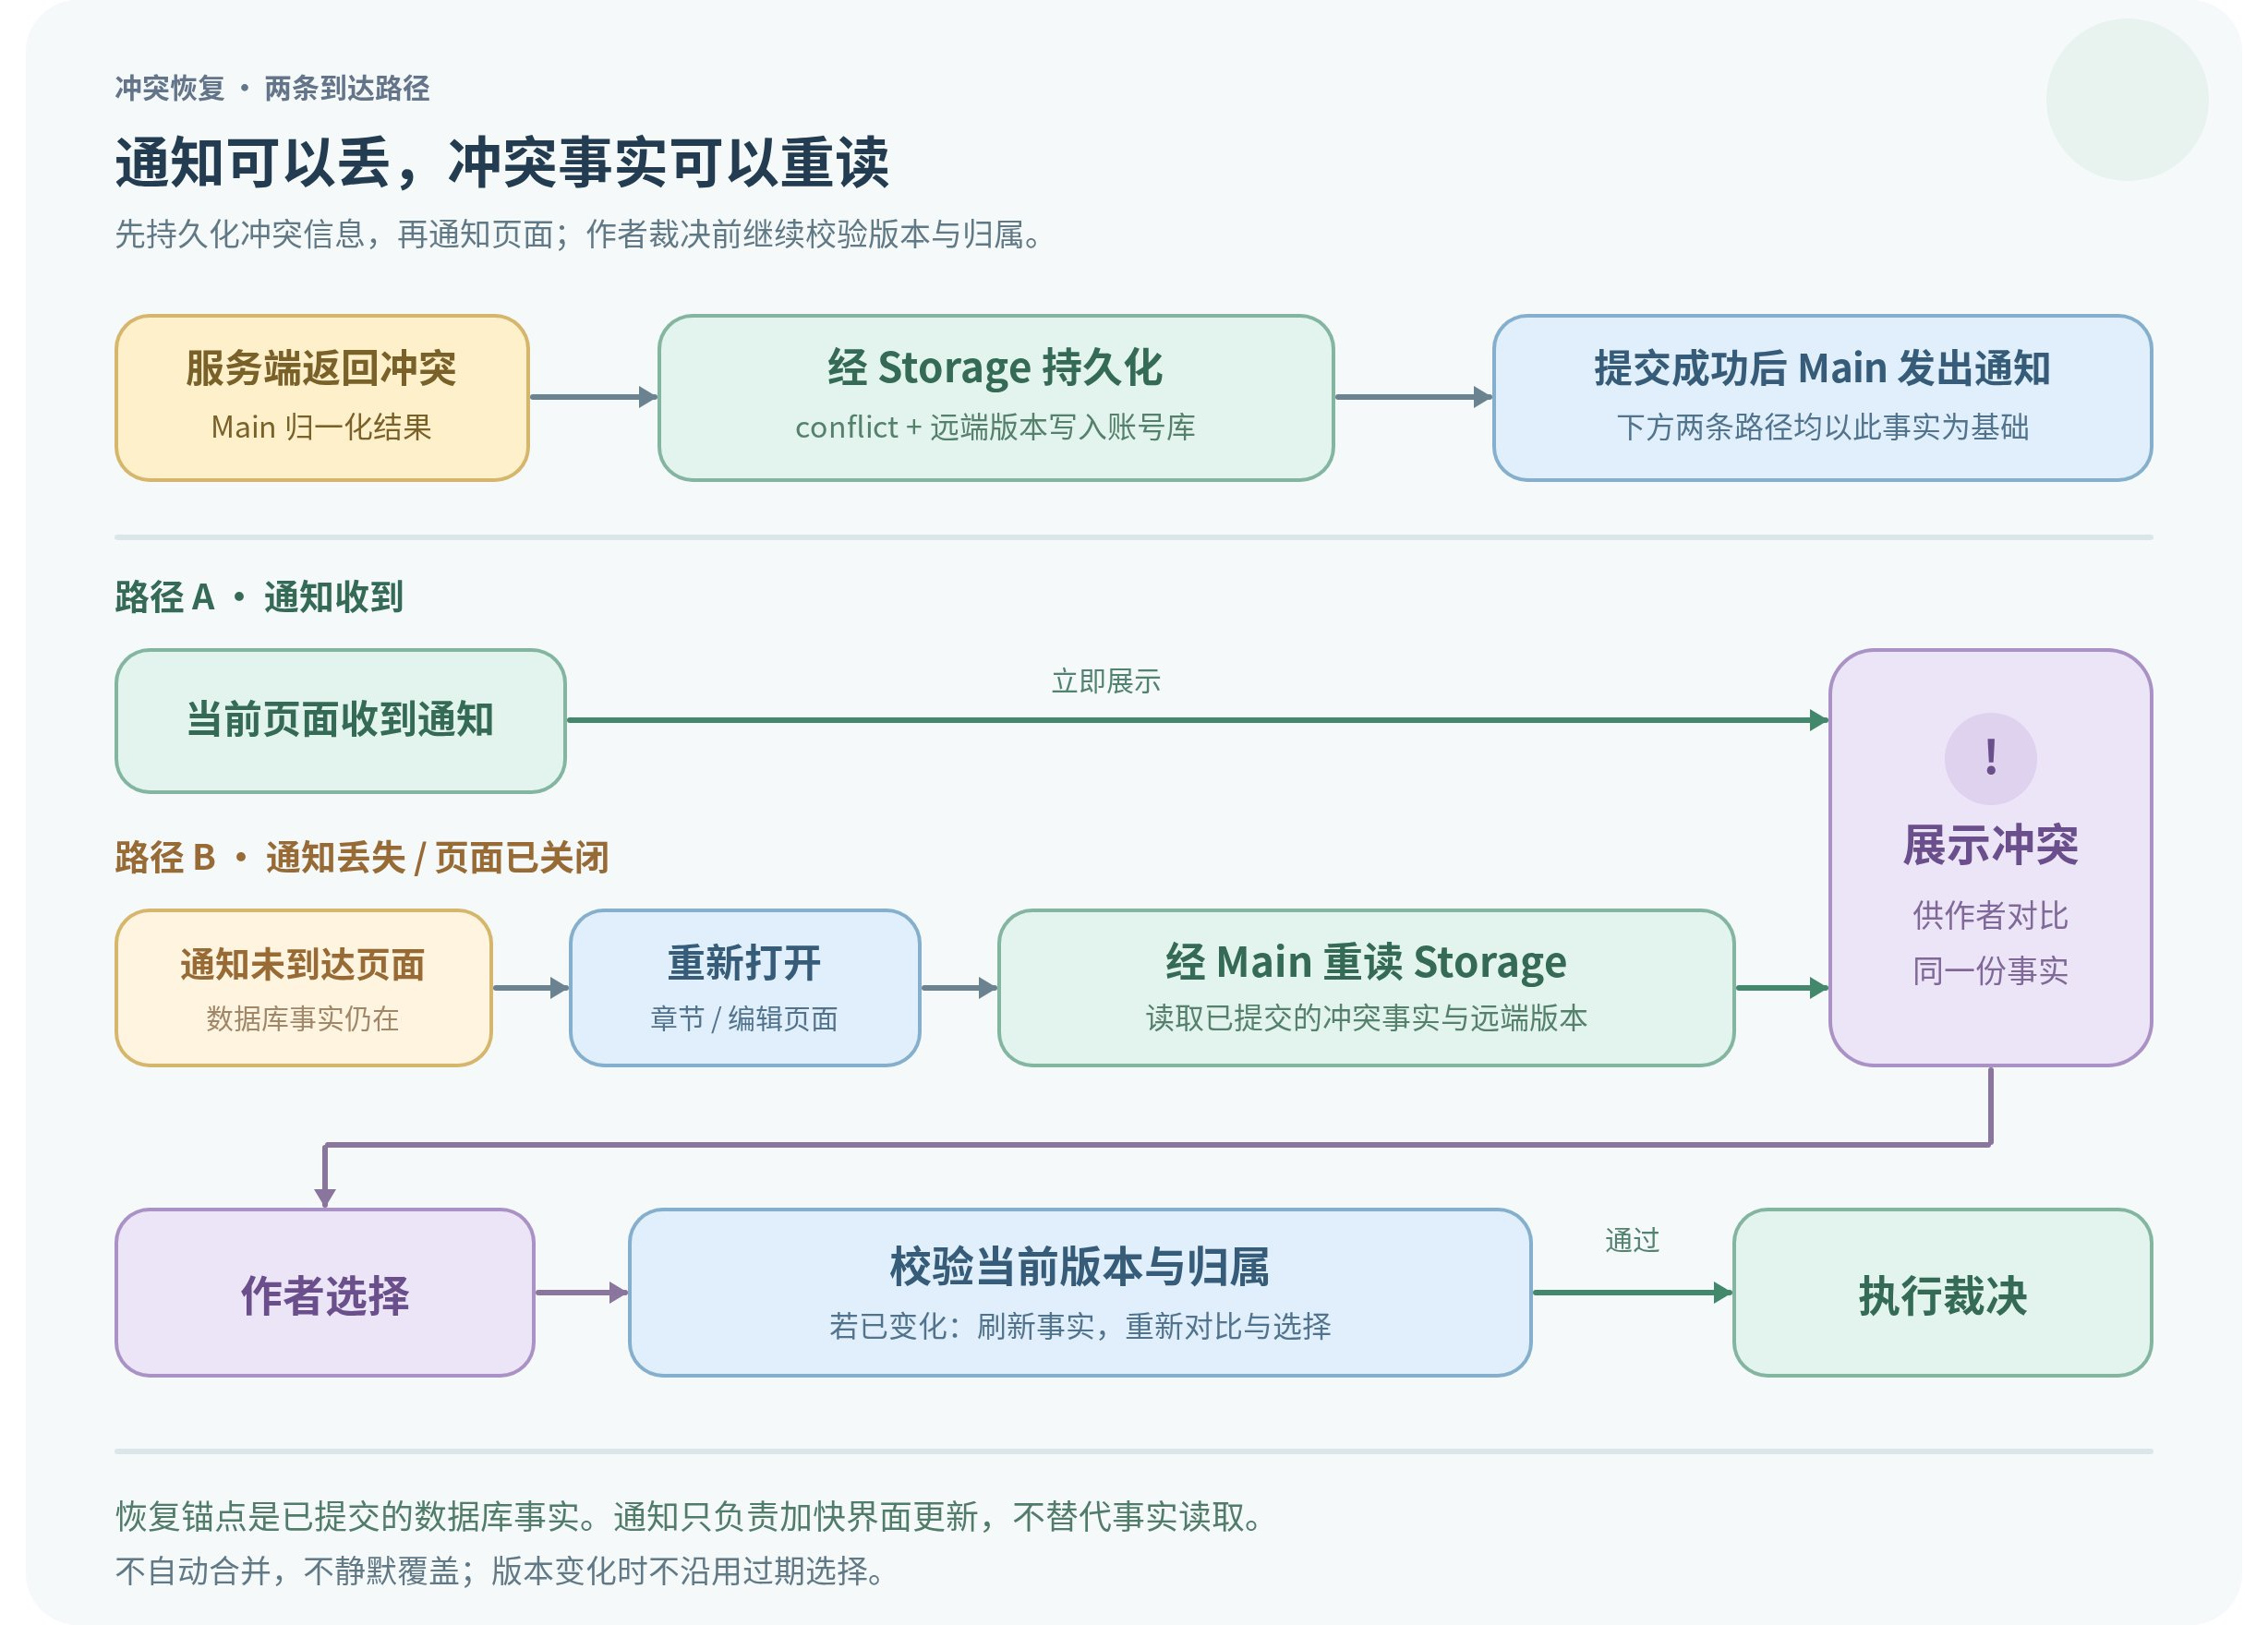
图 8|通知收到时直接展示冲突;通知丢失后,经 Main 重读 Storage 再恢复展示。两条路径都在作者选择后校验当前版本与归属。
如果只弹出提示,没有保存冲突状态,重启便可能失去处理线索。反过来,已展示旧对比结果也不能授权无条件覆盖新内容,裁决仍需检查当前事实。
重新打开,恢复哪些内容
💾 重新读取
已提交正文、dirty 和 conflict 从数据库恢复,后续同步与冲突处理据此继续。
🔄 重新判断
旧连接回执与“正在同步”等瞬时状态不会全部恢复,应结合新会话的当前状态判断。
同一作品复用编辑器会话;不同作品可并发完成首次初始化,持续同步与预取仍跟随当前激活作品。目录请求也会检查上下文与轮次,避免旧书的迟到结果干扰当前操作。
图中描述机制。离线重开、上传期间继续编辑、冲突通知丢失与提交后丢回执,仍需分别记录本地提交、远端响应和页面反馈;不据此宣称已完成断电、全平台或大作品性能验收。